Conditional Average Treatment Effect (heterogeneous treatment effects)
CATE=τ(x):=E[Y(1)−Y(0)∣X=x] の推定のため、複数の予測モデルを構築する手法
記法について
個体i
共変量(covariates)または特徴量(features):Xi∈X⊂Rm
潜在的結果(potential outcomes) Yi(0),Yi(1)∈R
処置割当(assignment) Di∈{0,1}
個体iのデータ:(Xi,Di,Yi(0),Yi(1))
個体iの観測データ:(Xi,Di,Yi)
観測された結果:Yi=DiYi(1)+(1−Di)Yi(0)
処置の割当確率(propensity): π(x)=P(Di=1∣Xi=x)
CATEの識別可能性
もしoverlap条件とunconfoundednessの仮定が満たされる場合、Potential Outcome Regressions
μd(x)=E[Y(d)∣X=x]=E[Y∣X=x,D=d] によりCATEが識別可能
CATEの推定の2つのアプローチ
2つに大別される
Indirect approach
τ^(x)=E^[Y∣X=x,D=1]−E^[Y∣X=x,D=0] Direct approach
CATEを直接推定する。
観測不可能なY(1)−Y(0)の代わりに pseudo-outcomes Yηを構築してXに回帰する。
τ^(x)=E^[Yη^∣X=x]( with E[Yη∣X=x]=E[Y(1)−Y(0)∣X=x]) η は 局外母数(nuisance parameters) で、傾向スコア(propensity score) π(x)=P(Di=1∣Xi=x)か 回帰面(regression surface) μd(x)=E[Y(d)∣X=x]が用いられる。
Indirect Approach
T-learner
回帰問題が解ける任意のアルゴリズムを2つ使い(two learners)、以下の3つのステップでCATEを推定する。
対照群の観測データをもとに、control response function μ0(x) を推定する
μ0(x)=E[Y(0)∣X=x] 同様に処置群でも treatment response functionを推定する。
μ1(x)=E[Y(1)∣X=x] 両者の差分をとり、T-learnerの完成
τ^(x)=μ^1(x)−μ^0(x) S-learner
処置の有無を表す変数Zを1つの回帰モデルの特徴量に含める(single learner)
μ(x,z):=E[Yobs∣X=x,Z=z] を作り、予測値の差分
τ^(x)=μ^(x,1)−μ^(x,0) によってCATEを推定する
X-learners
response functions μ0(x),μ1(x) を推定する
μ0(x)=E[Y(0)∣X=x]μ1(x)=E[Y(1)∣X=x] 対照群、処置群それぞれにおける個人の処置効果を実測値と予測値の差分で推定する( imputed treatment effects)
Δ~i(1):=Yi(1)−μ^0(Xi(1))Δ~i(0):=μ^1(Xi(1))−Yi(0) を使って、
τ1(x)=E[Δ~i(1)∣X=x]τ0(x)=E[Δ~i(0)∣X=x] と推定する。
もしうまく推定できてμ^0=μ0,μ^1=μ1であれば、
τ(x)=E[Δ~i(1)∣X=x]=E[Δ~i(0)∣X=x] (実測値のほうをΔ:=Y(1)−Y(0)とすると、τ(x)=E[Δ∣X=x]のため)
重み関数g∈[0,1]を使ってτ1(x),τ0(x)を重み付き和にしてCATEを推定する
τ^(x)=g(x)τ^0(x)+(1−g(x))τ^1(x) gはpropensity scoreが経験的によいらしい
Indirect Approachの欠点
1. T-learner が構造をうまく表現できない場合がある
τ(x)はμd(x)よりずっと単純な関数の可能性があり、その場合にうまく推定できないことがある。
Kennedy (2020)は、処置効果が同質(どのxの値のもとでもATEが一定)のデータセットに対してT-learnerが高い異質性を推定(異なるxに対して異なるATEを予測)したことを報告した。
2. S-learner がDiの変動を捉えないことがある
処置効果より大きな影響をもつ共変量があったとき、モデルは処置効果の変化を重視しないかもしれない(例:決定木でDが分岐に使われない)
3. T-learner, S-learnerどちらも複雑なCATEをコントロールできない
τ^(x)は明示的にモデリングされないため、その複雑さを制御できない
RA-learner
RA: regression adjustment
条件付き期待値をとると、
E[Y~RA,η^∣X=x]=π(x)[μ1(x)−μ^0(x)]+[1−π(x)][μ^1(x)−μ0(x)] もしμ^d(x)=μd(x)なら
=π(x)[μ1(x)−μ0(x)]+[1−π(x)][μ1(x)−μ0(x)]=μ1(x)−μ0(x)=τ(x) PW-learner
逆確率重み付け(IPW)推定量
↑Horvitz-Thompson transformation
条件付き期待値をとると、
E[Y~PW,η^∣X=x]=π^(x)π(x)μ1(x)−1−π^(x)1−π(x)μ0(x) もしπ^(x)=π(x)なら、
=μ1(x)−μ0(x)=τ(x) DR-learner
Doubly Robust推定量、あるいは Augmented Inverse Propensity-weighted (AIPW) 推定量と呼ばれるもの
条件付き期待値をとると
E[Y~DR,η^∣X=x]=π^(x)π(x)μ1(x)−1−π^(x)1−π(x)μ0(x)+[(1−π^(x)π(x))μ^1(x)−(1−1−π^(x)1−π(x))μ^0(x)] もし π^(x)=π(x) なら
=μ1(x)−μ0(x)+0×μ^1(x)−0×μ^0(x)=τ(x) もし μ^d(x)=μd(x) なら
=(1−π^(x)π(x)+π^(x)π(x))μ1(x)−(1−1−π^(x)1−π(x)+1−π^(x)1−π(x))μ0(x)=τ(x) Causal Forestsとのつながり
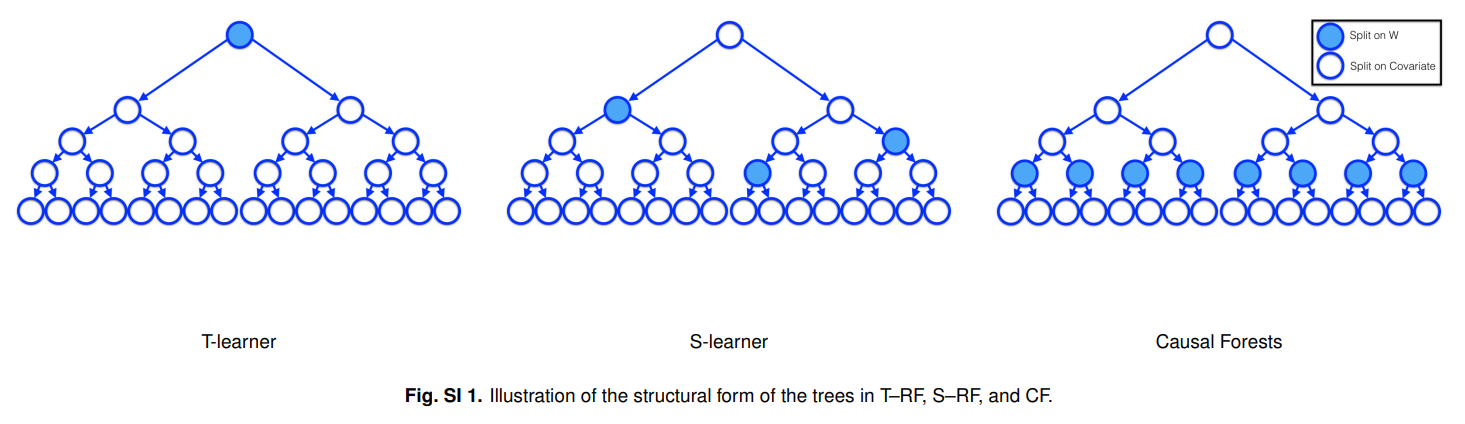
An estimator closely related to T–RF and S–RF is Causal Forests, because all three of these estimators can be defined as
τ^(x)=μ^(x,w=1)−μ^(x,w=0) where μ^(x,w) is a form of random forest with different constraints on the split on the treatment assignment
(Appendix of Künzel, et al. (2019))