Skip to article frontmatterSkip to article content
Site not loading correctly?

This may be due to an incorrect BASE_URL configuration. See the MyST Documentation for reference.

OLSのロバスト標準誤差

単回帰モデルの場合

nn個の観測値による単回帰モデルを想定する。

Yi=α+βXi+ui,i=1,2,…,nY_i=\alpha+\beta X_i+u_i, \quad i=1,2, \ldots, n

推定量

{∑u^i=∑(Yi−α^−β^Xi)=0∑u^iXi=∑(Yi−α^−β^Xi)Xi=0⇒α^=Yˉ−β^Xˉ,β^=SXYSXX\begin{cases} \sum \hat{u}_i=\sum(Y_i-\hat{\alpha}-\hat{\beta} X_i)=0 \\ \sum \hat{u}_i X_i=\sum(Y_i-\hat{\alpha}-\hat{\beta} X_i) X_i=0 \end{cases} \Rightarrow \hat{\alpha}=\bar{Y}-\hat{\beta} \bar{X}, \quad \hat{\beta}=\frac{S_{X Y}}{S_{X X}}

ここで、

SXX=∑(Xi−Xˉ)Xi,SXY=∑(Xi−Xˉ)YiS_{X X}=\sum(X_i-\bar{X}) X_i, \quad S_{X Y}=\sum(X_i-\bar{X}) Y_i

であるため、β^\hat{\beta}の式に代入すると

β^=SXYSXX=∑(Xi−Xˉ)YiSXX=∑(Xi−XˉSXX)Yi=∑wiYi,wi=Xi−XˉSXX\hat{\beta} =\frac{S_{X Y}}{S_{X X}} =\frac{\sum(X_i-\bar{X}) Y_i}{S_{X X}} =\sum\left(\frac{X_i-\bar{X}}{S_{X X}}\right) Y_i =\sum w_i Y_i, \quad w_i=\frac{X_i-\bar{X}}{S_{X X}}

となり、OLS推定量β^\hat\betaはwiw_iという重みによるYiY_iの線形和の形になっている

推定量の誤差

β^=∑wiYi=∑wi(α+βXi+ui)=α∑wi⏟=0+β∑wiXi⏟=1+∑wiui=β+∑wiui\begin{aligned} \hat{\beta} =\sum w_i Y_i =\sum w_i\left(\alpha+\beta X_i+u_i\right) &=\alpha \underbrace{\sum w_i}_{=0}+\beta \underbrace{\sum w_i X_i}_{=1}+\sum w_i u_i \\ & =\beta+\sum w_i u_i \end{aligned}

と、β^\hat\betaは真値β\betaの周りを誤差の加重和∑wiui\sum w_i u_iの分だけばらつく確率変数であり、一般にβ^≠β\hat\beta\neq\betaであることがわかる。

誤差項uiu_iの仮定により、推定誤差の期待値はゼロになる

E(∑i=1nwiui)=∑i=1nwiE(ui)⏟=0=0E(\sum_{i=1}^n w_i u_i) =\sum_{i=1}^n w_i \underbrace{ E(u_i) }_{=0} = 0

古典的線形回帰モデルの場合

古典的な線形回帰モデルの仮定のうち、

母分散が均一:Var⁡(ui)=E(ui2)=σ2\operatorname{Var}(u_i) = E(u_i^2) = \sigma^2

というものが関わってくる

推定量の分散

Var⁡(∑i=1nwiui)=∑i=1nwi2Var⁡(ui)=σ2∑i=1nwi2=σ2SXX\operatorname{Var}(\sum_{i=1}^n w_i u_i) = \sum_{i=1}^n w_i^2 \operatorname{Var}(u_i) = \sigma^2 \sum_{i=1}^n w_i^2 = \frac{\sigma^2}{S_{XX}}

最後の等式は∑i=1nwi2=1SXX\sum_{i=1}^n w_i^2=\frac{1}{S_{XX}}を利用している

よって

E(β^)=β,Var⁡(β^)=σ2SXX=σ2∑(Xi−Xˉ)2=σ2(n−1)sX2\mathrm{E}(\hat{\beta})=\beta , \quad \operatorname{Var}(\hat{\beta})=\frac{\sigma^2}{S_{X X}}=\frac{\sigma^2}{\sum(X_i-\bar{X})^2} =\frac{\sigma^2}{(n-1) s_X^2}

sX2s_X^2はXXの標本分散。サンプル数nnが大きいほどVar⁡(β^)\operatorname{Var}(\hat{\beta})は減少する

条件付き分散

Var⁡(β^∣X1,X2,…,Xn)=1SXX2∑(Xi−Xˉ)2σ2=σ2SXX2∑(Xi−Xˉ)2⏟=SXX=σ2SXX\begin{aligned} \operatorname{Var}\left(\hat{\beta} \mid X_1, X_2, \ldots, X_n\right) &=\frac{1}{S_{X X}^2} \sum\left(X_i-\bar{X}\right)^2 \sigma^2\\ &=\frac{\sigma^2}{S_{X X}^2} \underbrace{ \sum(X_i-\bar{X})^2 }_{= S_{X X}} \\ &=\frac{\sigma^2}{S_{X X}} \end{aligned}

不均一分散

Var⁡(ui)=E(ui2)=σi2\operatorname{Var}(u_i) = E(u_i^2) = \sigma^2_i

条件付き分散

不均一分散のもとで、OLS推定量の条件付き分散は

Var⁡(β^∣X1,X2,…,Xn)=1SXX2∑(Xi−Xˉ)2σi2\operatorname{Var}\left(\hat{\beta} \mid X_1, X_2, \ldots, X_n\right)=\frac{1}{S_{X X}^2} \sum\left(X_i-\bar{X}\right)^2 \sigma_i^2

と、均一分散の場合より複雑になる

漸近分散

OLSは漸近正規推定量になる

β^∼aN(β,Avar⁡(β^)),Avar⁡(β^)=1nσX4E[(Xi−μX)2σi2]\hat{\beta} \stackrel{a}{\sim} \mathrm{N}(\beta, \operatorname{Avar}(\hat{\beta})) ,\quad \operatorname{Avar}(\hat{\beta})=\frac{1}{n \sigma_X^4} \mathrm{E}\left[\left(X_i-\mu_X\right)^2 \sigma_i^2\right]

Avar⁡(β^)\operatorname{Avar}(\hat{\beta})は未知のσi2\sigma^2_iを含んでいるので、何らかの方法で推定する

Whiteの標準誤差

よく使われる推定量は、ホワイトの頑健な分散推定量

V=1nsX4⋅1n∑(Xi−Xˉ)2u^i2=1n2sX4∑(Xi−Xˉ)2u^i2V = \frac{1}{n s_X^4} \cdot \frac{1}{n} \sum\left(X_i-\bar{X}\right)^2 \hat{u}_i^2=\frac{1}{n^2 s_X^4} \sum\left(X_i-\bar{X}\right)^2 \hat{u}_i^2

その平方根はホワイトの標準誤差として知られる

 s.e. (β^)=V=1nsX2∑(Xi−Xˉ)2u^i2\text { s.e. }(\hat{\beta})=\sqrt{V}=\frac{1}{n s_X^2} \sqrt{\sum\left(X_i-\bar{X}\right)^2 \hat{u}_i^2}

重回帰モデルの場合

n∈Nn\in\mathbb{N}個の観測値があるとし、目的変数Y∈RnY\in \mathbb{R}^n、説明変数X∈Rn×mX\in\mathbb{R}^{n\times m}、誤差項u∈Rnu\in\mathbb{R}^nについて

Y=Xβ+uY = X \beta + u

という線形モデルを考える

推定量の誤差

OLS推定量

β^=(XTX)−1XTY\hat{\beta} = (X^T X)^{-1} X^T Y

を真値+αの形式にすると、

β^=(XTX)−1XTY=(XTX)−1XT(Xβ+u)=(XTX)−1XTX⏟=Iβ+(XTX)−1XTu=β+(XTX)−1XTu=β+(1nXTX)−11nXTu\begin{aligned} \hat{\beta} &= (X^T X)^{-1} X^T Y\\ &= (X^T X)^{-1} X^T (X\beta + u)\\ &= \underbrace{ (X^T X)^{-1} X^T X}_{=I} \beta + (X^T X)^{-1} X^T u\\ &= \beta + (X^T X)^{-1} X^T u\\ &= \beta + \left(\frac{1}{n} X^T X \right)^{-1} \frac{1}{n} X^T u\\ \end{aligned}

と表すことができる。

推定量の一致性

線形回帰モデルの外生性の仮定E(Xiui)=0E(X_i u_i) = 0が満たされるなら、

1nXTu=1n∑i=1nXiui→pE(Xiui)=0\frac{1}{n} X^T u = \frac{1}{n} \sum_{i=1}^n X_i u_i \overset{p}{\to} E(X_i u_i) = 0

であるから、誤差の項(XTX)−1XTu(X^T X)^{-1} X^T uは消失する

漸近正規性

OLS推定量

β^=β+(1NXTX)−11NXTu\hat{\beta} = \beta + \left(\frac{1}{N} X^T X\right)^{-1} \frac{1}{N} X^T u

を整理して以下の形にする

N(β^−β)=(1NXTX)−11NXTu\sqrt{N} (\hat{\beta} - \beta) = \left( \frac{1}{N} X^T X \right)^{-1} \frac{1}{\sqrt{N}} X^T u

1NXTu\frac{1}{\sqrt{N}} X^T uは1N∑i=1NXiui\frac{1}{\sqrt{N}} \sum^N_{i=1} X_i u_iと書くことができる。OLSの仮定より

E(Xiui)=0Var(Xiui)=E(u2XiXiT)\begin{align} E(X_i u_i) &= 0\\ Var(X_i u_i) &= E(u^2 X_i X^T_i) \end{align}

なので、中心極限定理により

1NXTu=1N∑i=1NXiui⟶dN(0,E(ui2XiXiT))\frac{1}{\sqrt{N}} X^T u = \frac{1}{\sqrt{N}} \sum^N_{i=1} X_i u_i \overset{d}{\longrightarrow} N\left( 0, E(u_i^2 X_i X_i^T) \right)

となる。

一致性のときに導出した

1NXTX⟶pE(XiXiT)\frac{1}{N} X^T X \overset{p}{\longrightarrow} E(X_i X_i^T)

を使うと、スルツキーの定理を用いて

N(β^−β)=(1NXTX)−11NXTu⟶d(E(XiXiT))−1×N(0,E(ui2XiXiT))=N(0,(E(XiXiT))−1E(ui2XiXiT)(E(XiXiT))−1)=N(0,V)\begin{align} \sqrt{N} (\hat{\beta} - \beta) &= \left( \frac{1}{N} X^T X \right)^{-1} \frac{1}{\sqrt{N}} X^T u \overset{d}{\longrightarrow} \left( E(X_i X_i^T) \right)^{-1} \times N\left( 0, E(u_i^2 X_i X_i^T) \right)\\ &= N\left( 0, \left( E(X_i X_i^T) \right)^{-1} E(u_i^2 X_i X_i^T) \left( E(X_i X_i^T) \right)^{-1} \right)\\ &= N(0, V)\\ \end{align}

となる。

スルツキーの定理

確率変数の行列YN,Y,XN,X∈RN×NY_N, Y, X_N, X \in \mathbb{R}^{N\times N}、正則行列C∈RN×NC \in \mathbb{R}^{N\times N}があるとする。

N→∞N\to \inftyのとき

XN→dXYN→dCX_N \xrightarrow{d} X\\ Y_N \xrightarrow{d} C\\

とする。

このとき、以下の結果が成り立ち、これを スルツキーの定理 という

  1. XN+YN→dX+CX_N + Y_N \xrightarrow{d} X + C

  2. YNXN→dCXY_N X_N \xrightarrow{d} C X

  3. YN−1XN→dC−1XY_N^{-1}X_N \xrightarrow{d} C^{-1} X

VVは以下のように一致推定できる

V^HC0=[1N∑i=1NXiXiT]−11N∑i=1Nu^i2XiXiT[1N∑i=1NXiXiT]−1=(1NXTX)−11NXTdiag⁡[u^i2]X(1NXTX)−1\begin{aligned} \hat{V}_{\mathrm{HC0}} & =\left[\frac{1}{N} \sum_{i=1}^N X_i X_i^T\right]^{-1} \frac{1}{N} \sum_{i=1}^N \hat{u}_i^2 X_i X_i^T\left[\frac{1}{N} \sum_{i=1}^N X_i X_i^T\right]^{-1} \\ & =\left(\frac{1}{N} X^T X\right)^{-1} \frac{1}{N} X^T \operatorname{diag}[\hat{u}_i^2] X\left(\frac{1}{N} X^T X\right)^{-1} \end{aligned}

ただし、diag⁡[u^i2]\operatorname{diag}[\hat{u}_i^2] は対角要素にu^12,…,u^N2\hat{u}_1^2, \dots, \hat{u}_N^2を並べた対角行列である。 これはHC0と呼ばれるタイプの誤差分散の推定量である

漸近分散の推定量

{estimatr}パッケージでの呼び名分散の推定量V^[β^]\widehat{\mathrm{V}}[\widehat{\beta}]notes
"classical"e⊤en−m(X⊤X)−1\frac{\mathbf{e}^\top\mathbf{e}}{n-m} (\mathbf{X}^{\top}\mathbf{X})^{-1}
"HC0"(X⊤X)−1X⊤diag[ei2]X(X⊤X)−1(\mathbf{X}^{\top}\mathbf{X})^{-1}\mathbf{X}^{\top}\mathrm{diag}\left[e_i^2\right]\mathbf{X}(\mathbf{X}^{\top}\mathbf{X})^{-1}
"HC1", "stata"nn−m(X⊤X)−1X⊤diag[ei2]X(X⊤X)−1\frac{n}{n-m}(\mathbf{X}^{\top}\mathbf{X})^{-1}\mathbf{X}^{\top}\mathrm{diag}\left[e_i^2\right]\mathbf{X}(\mathbf{X}^{\top}\mathbf{X})^{-1}Eicker-Huber-Whiteの分散推定量などと呼ばれる
"HC2" (default)(X⊤X)−1X⊤diag[ei21−hii]X(X⊤X)−1(\mathbf{X}^{\top}\mathbf{X})^{-1}\mathbf{X}^{\top}\mathrm{diag}\left[\frac{e_i^2}{1-h_{ii}}\right]\mathbf{X}(\mathbf{X}^{\top}\mathbf{X})^{-1}
"HC3"(X⊤X)−1X⊤diag[ei2(1−hii)2]X(X⊤X)−1(\mathbf{X}^{\top}\mathbf{X})^{-1}\mathbf{X}{\top}\mathrm{diag}\left[\frac{e_i^2}{(1-h_{ii})^2}\right]\mathbf{X}(\mathbf{X}^{\top}\mathbf{X})^{-1}
  • hii=Xi(XTX)−1XiTh_{ii}=X_i (X^T X)^{-1} X_i^T

  • ei=Yi−Xiβ^e_i = Y_i - X_i \hat{\beta}

  • mmは推定量の次元数

出所:estimatrパッケージのドキュメント

参考

実験(WIP)

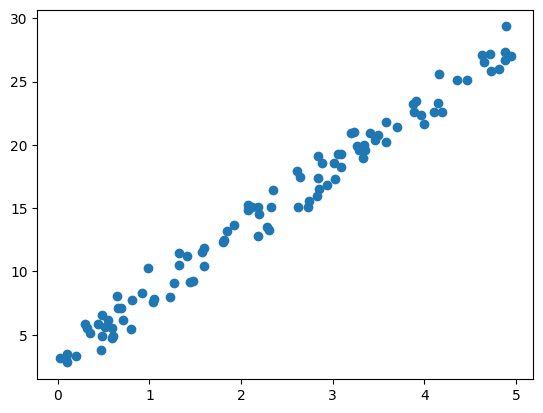
<Figure size 640x480 with 1 Axes>
array([3.22215108, 4.987387 ])
array([[100. , 236.39691976], [236.39691976, 766.62957534]])
0.11723457858134044