マージン ¶ データがクラス{ C 1 , C 2 } \{C_1, C_2\} { C 1 , C 2 } y ∈ { + 1 , − 1 } y \in \{+1, -1\} y ∈ { + 1 , − 1 } C 1 , C 2 C_1, C_2 C 1 , C 2 w = ( w 1 , . . . , w d ) T w=(w_1, ..., w_d)^T w = ( w 1 , ... , w d ) T b b b x = ( x 1 , . . . , x d ) T x=(x_1, ..., x_d)^T x = ( x 1 , ... , x d ) T
f ( x ) = w T x + b f(x) = w^T x + b f ( x ) = w T x + b と表すことができる。
識別境界(識別超平面)はf ( x ) = 0 f(x)=0 f ( x ) = 0 f ( x ) > = 0 f(x) >= 0 f ( x ) >= 0 f ( x ) < 0 f(x) < 0 f ( x ) < 0
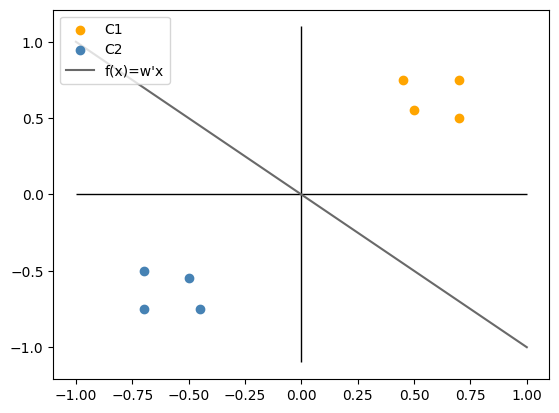
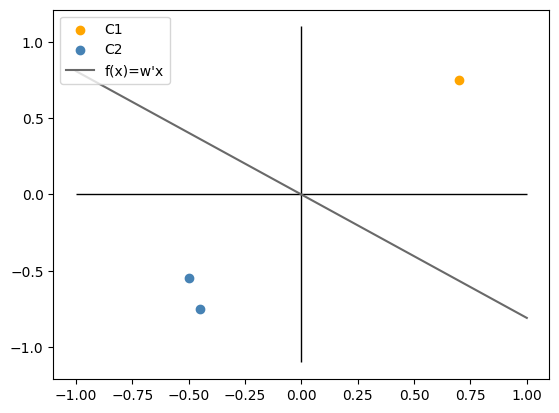
# 2次元に描いた場合
import numpy as np
import matplotlib.pyplot as plt

# このようなデータがあったとする
x_c1 = np.array([
    [.50, .55],
    [.45, .75],
    [.7, .50],
    [.7, .75],
])
x_c2 = - x_c1
X = np.append(x_c1, x_c2, axis=0)
y = np.array([1] * x_c1.shape[0] + [-1] * x_c2.shape[0])

# 重みベクトルが仮にこのようなwだったとする
w = np.array([1, 1])

# 描画範囲
x1 = np.linspace(-1, 1, 100)

def plot_hyperplane(X, y, w, ax, x1=x1):
    # データ点の散布図
    is_1 = y == 1
    ax.scatter(X[is_1, 0], X[is_1, 1], label="C1", color="orange")
    ax.scatter(X[~is_1, 0], X[~is_1, 1], label="C2", color="steelblue")

    # x軸, y軸を描く
    ax.hlines(0, -1, 1, colors="black", linewidth=1)
    ax.vlines(0, -1.1, 1.1, colors="black", linewidth=1)

    # 超平面:x2 = -(w1/w2) * x1の形にする
    # x1 = np.linspace(-1, 1, 100)
    x2 = -(w[0] / w[1]) * x1
    ax.plot(x1, x2, color="dimgray", label="f(x)=w'x")

    ax.legend(loc="upper left")
    return ax

fig, ax = plt.subplots()
plot_hyperplane(X, y, w, ax)
fig.show()
訓練データ中に存在しなかったノイズがテストデータに含まれていた場合、ノイズの分だけ識別を誤りやすくなる。
しかし、訓練データの点が識別超平面からある値h > 0 h > 0 h > 0 h h h
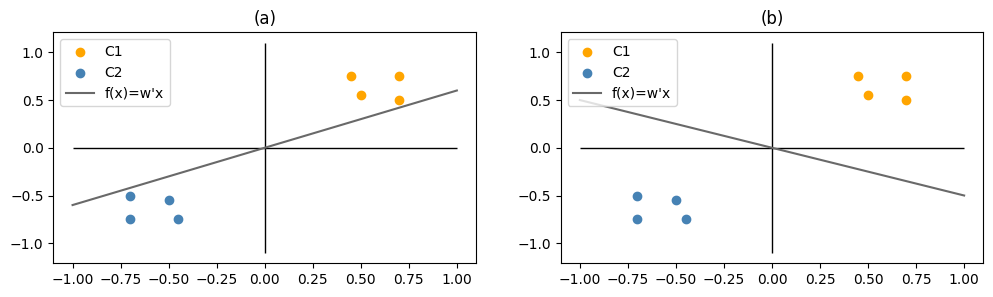
例えば、以下の図の(a)と(b)はいずれもサンプルをうまく分離できているものの、(a)よりも(b)のほうがデータ点と識別超平面の距離があり、ノイズに対してより頑健で望ましい分類器であると考えられる。
fig, axes = plt.subplots(ncols=2, figsize=(12, 3))

w_ = np.array([-3, 5])
plot_hyperplane(X, y, w_, axes[0])
axes[0].set(title="(a)")

w_ = np.array([1, 2])
plot_hyperplane(X, y, w_, axes[1])
axes[1].set(title="(b)")

fig.show()
となれば、 「識別超平面が訓練データからもっとも離れるように(両クラスの中間になるように)学習させればよいのではないか」 という考えが湧く。
これがサポートベクターマシン(Support Vector Machine: SVM)の考え方である。
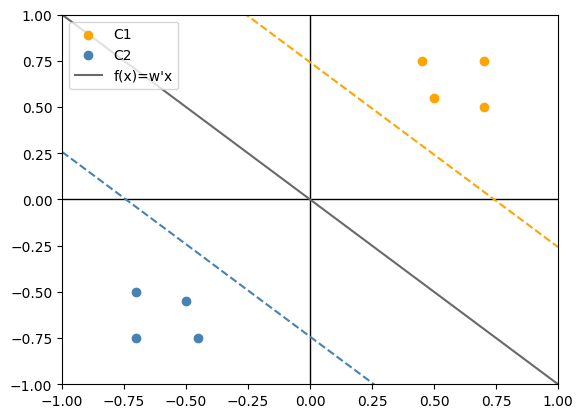
識別境界f ( x ) = 0 f(x) = 0 f ( x ) = 0 サポートベクトル (support vector)といい、サポートベクトルと識別境界との距離(識別境界と最も近いデータ点の距離)を マージン (margin)という。
ある識別関数に対してとれるマージンの大きさは、両クラスの学習データを識別関数の法線ベクトル上に射影した長さの最小値
ρ ( w ) = min x ∈ C 1 w T x ∣ ∣ w ∣ ∣ − max x ∈ C 2 w T x ∣ ∣ w ∣ ∣ \rho(w) = \min_{x \in C_1} \frac{w^T x}{||w||}
- \max_{x \in C_2} \frac{w^T x}{||w||} ρ ( w ) = x ∈ C 1 min ∣∣ w ∣∣ w T x − x ∈ C 2 max ∣∣ w ∣∣ w T x の半分である。ρ ( w ) \rho(w) ρ ( w ) ρ ( w ) \rho(w) ρ ( w )
fig, ax = plt.subplots()
plot_hyperplane(X, y, w, ax)

# 識別関数 f(x)=w'x の下での、class={C1, C2}のどちらに属するかについての判定結果
outputs = [w.T @ X[i, :] for i in range(X.shape[0])]
is_class_1 = [o >= 0 for o in outputs]
is_class_2 = np.invert(is_class_1)

# マージンとその合計ρ
margin1 = min([(w.T @ X[is_class_1, :][i, :] / np.linalg.norm(w)) for i in range(X[is_class_1, :].shape[0])])
margin2 = max([(w.T @ X[is_class_2, :][i, :] / np.linalg.norm(w)) for i in range(X[is_class_2, :].shape[0])])
rho = margin1 - margin2

# margins
m1 = -(w[0] / w[1]) * x1 + margin1
ax.plot(x1, m1, color="orange", linestyle="--")
m2 = -(w[0] / w[1]) * x1 + margin2
ax.plot(x1, m2, color="steelblue", linestyle="--")

ax.legend(loc="upper left")
ax.set(ylim=(-1,1), xlim=(-1,1))
fig.show()
ハードマージンSVM ¶ 学習データの集合をD L = { ( y i , x i ) } ( i = 1 , . . . , N ) \mathcal{D}_L = \{(y_i, x_i)\}(i=1,...,N) D L = {( y i , x i )} ( i = 1 , ... , N ) b b b w = ( w 1 , . . . , w d ) T w=(w_1, ..., w_d)^T w = ( w 1 , ... , w d ) T x = ( x 1 , . . . , x d ) T x=(x_1,...,x_d)^T x = ( x 1 , ... , x d ) T y i = { − 1 , + 1 } y_i=\{-1, +1\} y i = { − 1 , + 1 } x i ∈ R d x_i\in \mathbb{R}^d x i ∈ R d
線形識別関数のマージンをκ \kappa κ
∣ w T x i + b ∣ ≥ κ |w^T x_i + b| \geq \kappa ∣ w T x i + b ∣ ≥ κ が成り立つ。
係数ベクトルとバイアス項をマージンで正規化(w T x i = − b w^T x_i = -b w T x i = − b w , b w, b w , b
{ w T x i + b ≥ + 1 if y i = + 1 w T x i + b ≤ − 1 if y i = − 1 \begin{cases}
w^T x_i + b \geq +1 & \text{if} \hspace{0.5em} y_i = +1\\
w^T x_i + b \leq -1 & \text{if} \hspace{0.5em} y_i = -1
\end{cases} { w T x i + b ≥ + 1 w T x i + b ≤ − 1 if y i = + 1 if y i = − 1 となり、まとめて表記すると
y i × ( w T x i + b ) ≥ 1 y_i \times (w^T x_i + b) \geq 1 y i × ( w T x i + b ) ≥ 1 クラス間マージンは
ρ ( w , b ) = min x ∈ C y = + 1 w T x ∣ ∣ w ∣ ∣ − max x ∈ C y = − 1 w T x ∣ ∣ w ∣ ∣ \rho(w, b)
= \min_{x \in C_{y=+1}} \frac{w^T x}{||w||} - \max_{x\in C_{y=-1}} \frac{w^T x}{||w||} ρ ( w , b ) = x ∈ C y = + 1 min ∣∣ w ∣∣ w T x − x ∈ C y = − 1 max ∣∣ w ∣∣ w T x 第1項の分子はw T x i + b ≥ + 1 w^T x_i + b \geq +1 w T x i + b ≥ + 1 w T x i + b = 1 w^T x_i + b = 1 w T x i + b = 1 min w T x i = 1 − b \min w^T x_i = 1 - b min w T x i = 1 − b
第2項の分子はw T x i + b ≤ − 1 w^T x_i + b \leq -1 w T x i + b ≤ − 1 w T x i + b = − 1 w^T x_i + b = -1 w T x i + b = − 1 max w T x i = − 1 − b \max w^T x_i = -1 - b max w T x i = − 1 − b
であることを使えば
ρ ( w , b ) = min x ∈ C y = + 1 w T x ∣ ∣ w ∣ ∣ − max x ∈ C y = − 1 w T x ∣ ∣ w ∣ ∣ = 1 − b ∣ ∣ w ∣ ∣ − − 1 − b ∣ ∣ w ∣ ∣ = 1 + 1 − b + b ∣ ∣ w ∣ ∣ = 2 ∣ ∣ w ∣ ∣ \begin{align}
\rho(w, b)
&= \min_{x \in C_{y=+1}} \frac{w^T x}{||w||} - \max_{x\in C_{y=-1}} \frac{w^T x}{||w||}\\
&= \frac{1 - b}{||w||} - \frac{-1 - b}{||w||}\\
&= \frac{1 + 1 - b + b}{||w||}\\
&= \frac{2}{||w||}
\end{align} ρ ( w , b ) = x ∈ C y = + 1 min ∣∣ w ∣∣ w T x − x ∈ C y = − 1 max ∣∣ w ∣∣ w T x = ∣∣ w ∣∣ 1 − b − ∣∣ w ∣∣ − 1 − b = ∣∣ w ∣∣ 1 + 1 − b + b = ∣∣ w ∣∣ 2 となる。
識別関数の最大マージンは最大クラス間マージンの半分であるため、1 ∣ ∣ w ∣ ∣ \frac{1}{||w||} ∣∣ w ∣∣ 1
最適識別超平面 ¶ 最適な識別超平面は、「すべての訓練データを正しく識別できる」という制約条件
y i ( w T x i + b ) ≥ 1 ( i = 1 , . . . , N ) y_i (w^T x_i + b) \geq 1 \hspace{1em} (i=1,...,N) y i ( w T x i + b ) ≥ 1 ( i = 1 , ... , N ) の下でマージン1 ∥ w ∥ \frac{1}{\|w\|} ∥ w ∥ 1 ∥ w ∥ \|w\| ∥ w ∥
w 0 = min ∥ w ∥ w_0 = \min \|w\| w 0 = min ∥ w ∥ として求めることができる。これは次の不等式制約条件つき最適化問題を解くことで得られる。
minimize L p ( w ) = 1 2 w T w subject to y i ( w T x i + b ) ≥ 1 ; ∀ i \begin{align}
\text{minimize} & \hspace{1em} L_p(w) = \frac{1}{2} w^T w\\
\text{subject to} & \hspace{1em} y_i( w^T x_i + b) \geq 1; \ \forall i
\end{align} minimize subject to L p ( w ) = 2 1 w T w y i ( w T x i + b ) ≥ 1 ; ∀ i この問題はラグランジュの未定乗数法を用いて解かれ、次のラグランジュ関数として定式化される
L ~ p ( w , b , α ) = 1 2 w T w − ∑ i = 1 N α i ( y i ( w T x i + b ) − 1 ) \tilde{L}_p(w, b, \alpha) = \frac{1}{2} w^T w
- \sum^N_{i=1} \alpha_i (y_i (w^T x_i + b) - 1) L ~ p ( w , b , α ) = 2 1 w T w − i = 1 ∑ N α i ( y i ( w T x i + b ) − 1 ) ここでα = ( α 1 , . . . , α N ) T \alpha=(\alpha_1, ..., \alpha_N)^T α = ( α 1 , ... , α N ) T α i ≥ 0 \alpha_i \geq 0 α i ≥ 0 α i \alpha_i α i
この最適化問題の解w ∗ w_* w ∗ b ∗ b_* b ∗ KKT(Karush-Kuhn-Tucker)条件 を満たす解として知られている。
(1) ∂ L ~ p ( w , b , α ) ∂ w ∣ w = w ∗ = w ∗ − ∑ i = 1 N α i y i x i = 0 \displaystyle \frac{\partial \tilde{L}_p(w, b, \alpha)}{\partial w}|_{w=w_*} = w_* - \sum^N_{i=1} \alpha_i y_i x_i = 0 ∂ w ∂ L ~ p ( w , b , α ) ∣ w = w ∗ = w ∗ − i = 1 ∑ N α i y i x i = 0
(2) ∂ L ~ p ( w , b , α ) ∂ b = ∑ i = 1 N α i y i = 0 \displaystyle \frac{\partial \tilde{L}_p(w, b, \alpha)}{\partial b} = \sum^N_{i=1} \alpha_i y_i = 0 ∂ b ∂ L ~ p ( w , b , α ) = i = 1 ∑ N α i y i = 0
(3) y i ( w T x i + b ) − 1 ≥ 0 y_i(w^T x_i + b) - 1 \geq 0 y i ( w T x i + b ) − 1 ≥ 0
(4) α i ≥ 0 \alpha_i \geq 0 α i ≥ 0
(5) α i ( y i ( w T x i + b ) − 1 ) = 0 \alpha_i (y_i (w^T x_i + b) - 1) = 0 α i ( y i ( w T x i + b ) − 1 ) = 0
ラグランジュ関数のw w w w ∗ w_* w ∗
L d ( α ) = 1 2 w ∗ T w ∗ − ∑ i = 1 N α i y i w ∗ T x i − b ∑ i = 1 N α i y i + ∑ i = 1 N α i = ∑ i = 1 N α i − 1 2 w ∗ T w ∗ ( ∵ ∑ i = 1 N α i y i = 0 ) = ∑ i = 1 N α i − 1 2 ∑ i = 1 N ∑ j = 1 N α i α j y i y j x i T x j \begin{align}
L_d(\alpha)
&= \frac{1}{2} {w_*}^T w_* - \sum^N_{i=1} \alpha_i y_i w_*^T x_i - b \sum^N_{i=1} \alpha_i y_i + \sum^N_{i=1} \alpha_i\\
&= \sum^N_{i=1} \alpha_i - \frac{1}{2} w_*^T w_* \hspace{2em} (\because \sum^N_{i=1} \alpha_i y_i = 0)\\
&= \sum^N_{i=1} \alpha_i - \frac{1}{2} \sum^N_{i=1} \sum^N_{j=1} \alpha_i \alpha_j y_i y_j x_i^T x_j
\end{align} L d ( α ) = 2 1 w ∗ T w ∗ − i = 1 ∑ N α i y i w ∗ T x i − b i = 1 ∑ N α i y i + i = 1 ∑ N α i = i = 1 ∑ N α i − 2 1 w ∗ T w ∗ ( ∵ i = 1 ∑ N α i y i = 0 ) = i = 1 ∑ N α i − 2 1 i = 1 ∑ N j = 1 ∑ N α i α j y i y j x i T x j となり、ラグランジュ未定乗数のみの関数にすることができる
KKT条件(1)より最適解はw ∗ = ∑ i = 1 N α i y i x i w_* = \sum^N_{i=1} \alpha_i y_i x_i w ∗ = ∑ i = 1 N α i y i x i α i \alpha_i α i
maximize L d ( α ) = α T 1 − 1 2 α T H α subject to α T y = 0 \begin{align}
\text{maximize} & \hspace{1em} L_d(\alpha) = \alpha^T \boldsymbol{1} - \frac{1}{2} \alpha^T H \alpha \\
\text{subject to} & \hspace{1em} \alpha^T y = 0
\end{align} maximize subject to L d ( α ) = α T 1 − 2 1 α T H α α T y = 0 ここで
1 = ( 1 , . . . , 1 ) T H = ( H i j = y i y j x i T x j ) y = ( y 1 , . . . , y N ) T \begin{align}
\boldsymbol{1} &= (1,...,1)^T\\
H &= (H_{ij} = y_i y_j x_i^T x_j)\\
y &= (y_1,...,y_N)^T\\
\end{align} 1 H y = ( 1 , ... , 1 ) T = ( H ij = y i y j x i T x j ) = ( y 1 , ... , y N ) T である。
双対問題のラグランジュ関数は、ラグランジュ未定乗数をβ \beta β
L ~ d ( α , β ) = α T 1 − 1 2 α T H α − β α T y \tilde{L}_d(\alpha, \beta) = \alpha^T \boldsymbol{1} - \frac{1}{2} \alpha^T H \alpha - \beta \alpha^T y L ~ d ( α , β ) = α T 1 − 2 1 α T H α − β α T y KKT条件(5)よりα i ( y i ( w T x i + b ) − 1 ) = 0 \alpha_i (y_i (w^T x_i + b) - 1) = 0 α i ( y i ( w T x i + b ) − 1 ) = 0 i i i
{ α i > 0 if y i ( w T x i + b ) − 1 = 0 α i = 0 if y i ( w T x i + b ) − 1 ≠ 0 \begin{cases}
\alpha_i > 0 & \text{if} \hspace{0.5em} y_i(w^T x_i + b) - 1 = 0\\
\alpha_i = 0 & \text{if} \hspace{0.5em} y_i(w^T x_i + b) - 1 \neq 0
\end{cases} { α i > 0 α i = 0 if y i ( w T x i + b ) − 1 = 0 if y i ( w T x i + b ) − 1 = 0 となる。α i > 0 \alpha_i > 0 α i > 0 x i x_i x i サポートベクトル という。
最適なバイアスb ∗ b_* b ∗ x s x_s x s
y s ( w ∗ T x s + b ∗ ) − 1 = 0 y_s (w_*^T x_s + b_*) - 1 = 0 y s ( w ∗ T x s + b ∗ ) − 1 = 0 を解いて求めるか、それらの平均を用いる。
主問題をそのままソルバーに通すパターン
min w 1 2 w T w = 1 2 ∥ w ∥ 2 2 s.t. y i ( w T x i + b ) ≥ 1 ; ∀ i \begin{align}
\min_w & \hspace{1em} \frac{1}{2} w^T w = \frac{1}{2} \|w\|^2_2\\
\text{s.t.} & \hspace{1em} y_i( w^T x_i + b) \geq 1; \ \forall i
\end{align} w min s.t. 2 1 w T w = 2 1 ∥ w ∥ 2 2 y i ( w T x i + b ) ≥ 1 ; ∀ i import cvxpy as cp
n = X.shape[0]
d = X.shape[1]
b = cp.Variable()
w = cp.Variable(d)
prob = cp.Problem(cp.Minimize( (1/2) * cp.norm(w, 2)**2 ),
[y[i] * (w.T @ X[i, :] + b) >= 1 for i in range(n)])
prob.solve()
print("The optimal value is", prob.value)
print("w is", w.value)
print("b is", b.value)The optimal value is 0.9049773766503894
w is [0.90497738 0.99547511]
b is -1.2800914228520561e-17
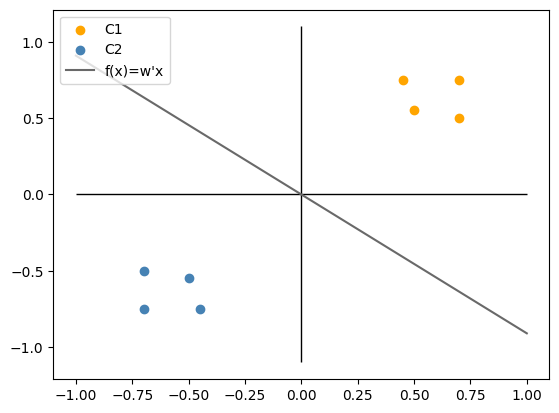
w = w.value

fig, ax = plt.subplots()
plot_hyperplane(X, y, w, ax)
fig.show()
双対問題をソルバーに通すパターン ¶ 双対問題
maximize L d ( α ) = α T 1 − 1 2 α T H α subject to α T y = 0 \begin{align}
\text{maximize} & \hspace{1em} L_d(\alpha) = \alpha^T \boldsymbol{1} - \frac{1}{2} \alpha^T H \alpha \\
\text{subject to} & \hspace{1em} \alpha^T y = 0
\end{align} maximize subject to L d ( α ) = α T 1 − 2 1 α T H α α T y = 0 をcvxpyの二次計画問題のソルバー
# データ数が多くなるとソルバーが上手く動かないので一旦暫定的対処としてデータ数を絞る
y = y[3:6]
X = X[3:6]
# Hを作成
n = X.shape[0]
H = np.zeros(shape=(n, n))
for i in range(n):
    for j in range(n):
        H[i, j] = y[i] * y[i] * X[i] @ X[j]

ones = np.ones(shape=(n, ))
import cvxpy as cp

alpha = cp.Variable(n)  # 長さnのベクトル
prob = cp.Problem(cp.Maximize( alpha.T @ ones - (1/2) * cp.quad_form(alpha, H) ),
                  [alpha.T @ y == 0])
prob.solve()
print("The optimal value is", prob.value)
print("alpha is", alpha.value)

a = alpha.value
w = sum([a[i] * y[i] * X[i] for i in range(n)])
print(f"w={w}")
The optimal value is inf
alpha is None
---------------------------------------------------------------------------
TypeError Traceback (most recent call last)
Cell In[91], line 11
8 print ( " alpha is " , alpha . value)
10 a = alpha . value
---> 11 w = sum ([a[i] * y[i] * X[i] for i in range (n)])
12 print ( f " w= { w } " )
Cell In[91], line 11 , in <listcomp> (.0)
8 print ( " alpha is " , alpha . value)
10 a = alpha . value
---> 11 w = sum ([ a [ i ] * y[i] * X[i] for i in range (n)])
12 print ( f " w= { w } " )
TypeError : 'NoneType' object is not subscriptable fig, ax = plt.subplots()
plot_hyperplane(X, y, w, ax)
fig.show()from sklearn import svm
clf = svm.SVC(random_state=0, kernel='linear', shrinking=False)
clf.fit(X, y)
print(f"b={clf.intercept_}, w={clf.coef_}")b=[-0.], w=[[0.90497736 0.9954751 ]]
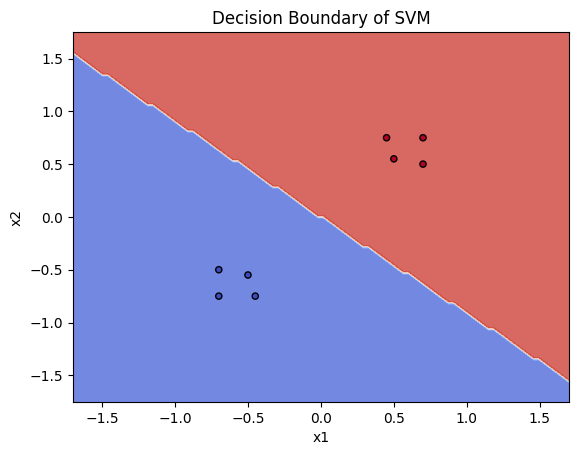
from sklearn.inspection import DecisionBoundaryDisplay
fig, ax = plt.subplots()
disp = DecisionBoundaryDisplay.from_estimator(
    clf,
    X,
    response_method="predict",
    cmap=plt.cm.coolwarm,
    alpha=0.8,
    ax=ax,
    xlabel="x1",
    ylabel="x2",
)
ax.scatter(X[:, 0], X[:, 1], c=y, cmap=plt.cm.coolwarm, s=20, edgecolors="k")
ax.set(title="Decision Boundary of SVM")
fig.show()
ソフトマージンSVM ¶ C-SVM ¶ スラック変数と呼ばれる変数ξ i \xi_i ξ i
{ ξ i = 0 ( マージン内で正しく識別できる場合 ) 0 < ξ i ≤ 1 ( マージン境界を超えるが正しく識別できる場合 ) ξ i > 1 ( 識別境界を超えて誤識別される場合 ) \begin{cases}
\xi_i = 0 & (マージン内で正しく識別できる場合)\\
0 < \xi_i \leq 1 & (マージン境界を超えるが正しく識別できる場合)\\
\xi_i > 1 & (識別境界を超えて誤識別される場合)
\end{cases} ⎩ ⎨ ⎧ ξ i = 0 0 < ξ i ≤ 1 ξ i > 1 ( マージン内で正しく識別できる場合 ) ( マージン境界を超えるが正しく識別できる場合 ) ( 識別境界を超えて誤識別される場合 ) 以下のように書くこともできる
ξ i = max [ 0 , 1 − y i ( w T x i + b ) ] = f + ( 1 − y i ( w T x i + b ) ) \xi_i
= \max[0, 1-y_i(w^T x_i + b)]
= f_{+}(1 - y_i(w^T x_i + b)) ξ i = max [ 0 , 1 − y i ( w T x i + b )] = f + ( 1 − y i ( w T x i + b )) ここでf + ( x ) f_{+}(x) f + ( x )
f + ( x ) : = { x ( x > 0 の場合 ) 0 ( それ以外 ) f_{+}(x) :=
\begin{cases}
x & (x > 0の場合)\\
0 & (それ以外)
\end{cases} f + ( x ) := { x 0 ( x > 0 の場合 ) ( それ以外 ) である
ソフトマージン識別器の主問題は以下のように定式化される。
minimize L p ( w , ξ ) = 1 2 w T w + C ∑ i = 1 N ξ i subject to y i ( w T x i + b ) − 1 + ξ i ≥ 0 ξ i ≥ 0 \begin{align}
\text{minimize} & \hspace{1em} L_p(w, \xi) = \frac{1}{2} w^T w + C\sum^N_{i=1} \xi_i \\
\text{subject to} & \hspace{1em} y_i( w^T x_i + b) - 1 + \xi_i \geq 0 \\
& \hspace{1em} \xi_i \geq 0
\end{align} minimize subject to L p ( w , ξ ) = 2 1 w T w + C i = 1 ∑ N ξ i y i ( w T x i + b ) − 1 + ξ i ≥ 0 ξ i ≥ 0 すべての訓練データのスラック変数の和∑ ξ i ( ξ i ≥ 0 ) \sum \xi_i (\xi_i \geq 0) ∑ ξ i ( ξ i ≥ 0 ) C C C C C C w w w
このSVMはC C C
ν-SVM ¶ 上限サポートベクトル(マージン誤りξ i > 0 \xi_i > 0 ξ i > 0 ν \nu ν
カーネルトリック ¶ カーネルモデル ¶ 線形モデルをカーネルモデルに拡張することを考える。
線形モデル
f l i n e a r ( x i ) = w T x i + b f^{linear}(x_i) = w^T x_i + b f l in e a r ( x i ) = w T x i + b x i = ( x i 1 , … , x i D ) x_i = (x_{i1}, \dots, x_{iD}) x i = ( x i 1 , … , x i D )
w = ( x 1 , … , x D ) T w=(x_1,\dots,x_D)^T w = ( x 1 , … , x D ) T
カーネルモデル
f k e r n e l ( x i ) = ∑ j = 1 N w j ϕ ( x i ) T ϕ ( x j ) + b f^{kernel}(x_i) = \sum^N_{j=1} w_j \phi(x_i)^T \phi(x_j) + b f k er n e l ( x i ) = j = 1 ∑ N w j ϕ ( x i ) T ϕ ( x j ) + b x i = ( x i 1 , … , x i D ) x_i = (x_{i1}, \dots, x_{iD}) x i = ( x i 1 , … , x i D )
w = ( x 1 , … , x N ) T w=(x_1,\dots,x_N)^T w = ( x 1 , … , x N ) T
ここでϕ ( ⋅ ) \phi(\cdot) ϕ ( ⋅ ) ϕ ( ⋅ ) \phi(\cdot) ϕ ( ⋅ ) x x x ϕ ( x i ) T ϕ ( x ) \phi(x_i)^T \phi(x) ϕ ( x i ) T ϕ ( x )
カーネルモデルはN N N N N N
カーネルトリック ¶ ϕ ( x ) \phi(x) ϕ ( x ) 正定値関数 (positive definite function)を用いる。
関数 k ( x i , x j ) k(x_i, x_j) k ( x i , x j )
(1) 対称性:k ( x i , x j ) = k ( x j , x i ) k(x_i, x_j)=k(x_j, x_i) k ( x i , x j ) = k ( x j , x i )
(2) 正定値性:デー夕点 x 1 , x 2 , … , x N \mathrm{x}_1, \mathrm{x}_2, \ldots, \mathrm{x}_N x 1 , x 2 , … , x N グラム行列 (Gram matrix) K K K
K = ( k ( x 1 , x 1 ) k ( x 1 , x 2 ) ⋯ k ( x 1 , x N ) k ( x 2 , x 1 ) k ( x 2 , x 2 ) ⋯ k ( x 2 , x N ) ⋮ ⋮ ⋱ ⋮ k ( x N , x 1 ) k ( x N , x 2 ) ⋯ k ( x N , x N ) ) K = \begin{pmatrix}
k(x_1, x_1) & k(x_1, x_2) & \cdots & k(x_1, x_N) \\
k(x_2, x_1) & k(x_2, x_2) & \cdots & k(x_2, x_N) \\
\vdots & \vdots & \ddots & \vdots \\
k(x_N, x_1) & k(x_N, x_2) & \cdots & k(x_N, x_N)
\end{pmatrix} K = ⎝ ⎛ k ( x 1 , x 1 ) k ( x 2 , x 1 ) ⋮ k ( x N , x 1 ) k ( x 1 , x 2 ) k ( x 2 , x 2 ) ⋮ k ( x N , x 2 ) ⋯ ⋯ ⋱ ⋯ k ( x 1 , x N ) k ( x 2 , x N ) ⋮ k ( x N , x N ) ⎠ ⎞ すなわち、任意の N N N z z z z ⊤ K z ≥ 0 z^{\top} K z \geq 0 z ⊤ Kz ≥ 0
正定値関数 k ( x i , x j ) k(x_i, x_j) k ( x i , x j ) 再生核ヒルベルト空間 H k \mathcal{H}_k H k ϕ ( x i ) , ϕ ( x j ) ∈ H k \phi(x_i), \phi(x_j) \in \mathcal{H}_k ϕ ( x i ) , ϕ ( x j ) ∈ H k
k ( x i , x j ) = ϕ ( x i ) T ϕ ( x j ) k(x_i, x_j) = \phi(x_i)^T \phi(x_j) k ( x i , x j ) = ϕ ( x i ) T ϕ ( x j ) これを用いて高次元空間上での内積をより単純な2変数関数の計算k ( ⋅ , ⋅ ) k(\cdot, \cdot) k ( ⋅ , ⋅ ) k ( ⋅ , ⋅ ) k(\cdot, \cdot) k ( ⋅ , ⋅ ) カーネル関数 (kernel function)、グラム行列K K K カーネル行列 (kernel matrix) と呼ぶ。
カーネル関数とカーネル行列を用いると、カーネルモデルは以下のように表現できる
カーネル行列を用いたカーネルモデル
f k e r n e l ( x i ) = ∑ j = 1 N w j k ( x i , x j ) + b = K i : w + b f^{kernel}(x_i) = \sum^N_{j=1} w_j k(x_i, x_j) + b
= K_{i:} w + b f k er n e l ( x i ) = j = 1 ∑ N w j k ( x i , x j ) + b = K i : w + b ここでK i : K_{i:} K i : i i i
カーネル関数の例 ¶ 線形カーネル(linear kernel)
k ( x i , x j ) = x i x j T k(x_i, x_j) = x_i x_j^T k ( x i , x j ) = x i x j T 入力をそのまま出力する写像関数ϕ ( x ) = x T \phi(x)=x^T ϕ ( x ) = x T
ガウスカーネル(Gaussian kernel)
k ( x i , x j ) = exp ( − ∥ x i − x j ∥ 2 2 σ 2 ) k(x_i, x_j) = \exp \left( -\frac{\| x_i-x_j \|^2}{2\sigma^2} \right) k ( x i , x j ) = exp ( − 2 σ 2 ∥ x i − x j ∥ 2 ) min w , b , ξ L p ( w , ξ ) = 1 2 w T w + C ∑ i = 1 N ξ i s. t. y i ( K i : w + b ) − 1 + ξ i ≥ 0 ξ i ≥ 0 ∀ i \begin{align}
\min_{w,b,\xi} & \hspace{1em} L_p(w, \xi) = \frac{1}{2} w^T w + C\sum^N_{i=1} \xi_i \\
\text{s. t.} & \hspace{1em} y_i ( K_{i:} w + b) - 1 + \xi_i \geq 0 \\
& \hspace{1em} \xi_i \geq 0 ~ \forall i
\end{align} w , b , ξ min s. t. L p ( w , ξ ) = 2 1 w T w + C i = 1 ∑ N ξ i y i ( K i : w + b ) − 1 + ξ i ≥ 0 ξ i ≥ 0 ∀ i max λ L ( λ , γ ∗ , w ∗ , b ∗ , ξ ∗ ) = − 1 2 ∑ i = 1 N ∑ j = 1 N λ i y i k ( x i , x j ) t j λ j + ∑ i = 1 N λ i s.t. − λ i ≤ 0 λ i ≤ C ∑ i = 1 N λ i y i = 0 ∀ i \begin{aligned}
\max _{\boldsymbol{\lambda}} \mathcal{L}\left(\boldsymbol{\lambda}, \boldsymbol{\gamma}^*, \mathbf{w}^*, b^*, \boldsymbol{\xi}^*\right)
= & -\frac{1}{2} \sum_{i=1}^N \sum_{j=1}^N \lambda_i y_i k (x_i, x_j) t_j \lambda_j+\sum_{i=1}^N \lambda_i \\
\text { s.t. } \quad & -\lambda_i \leq 0 \\
& \lambda_i \leq C \\
& \sum_{i=1}^N \lambda_i y_i=0 \forall_i
\end{aligned} λ max L ( λ , γ ∗ , w ∗ , b ∗ , ξ ∗ ) = s.t. − 2 1 i = 1 ∑ N j = 1 ∑ N λ i y i k ( x i , x j ) t j λ j + i = 1 ∑ N λ i − λ i ≤ 0 λ i ≤ C i = 1 ∑ N λ i y i = 0 ∀ i
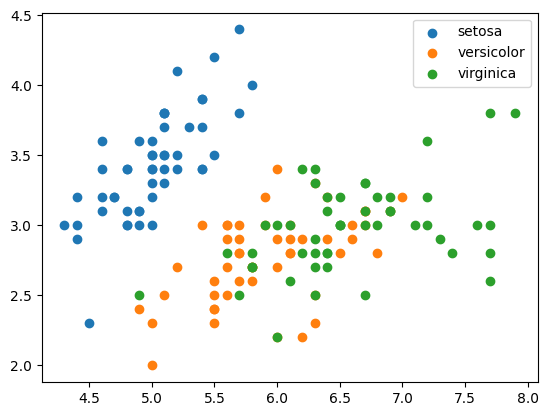
from sklearn import datasets
X, y = datasets.load_iris(return_X_y=True, as_frame=False)
X = X[:, 0:2]

fig, ax = plt.subplots()
for c, label in enumerate(['setosa', 'versicolor', 'virginica']):
    is_c = y == c
    ax.scatter(X[is_c, 0], X[is_c, 1], label=label)
ax.legend()
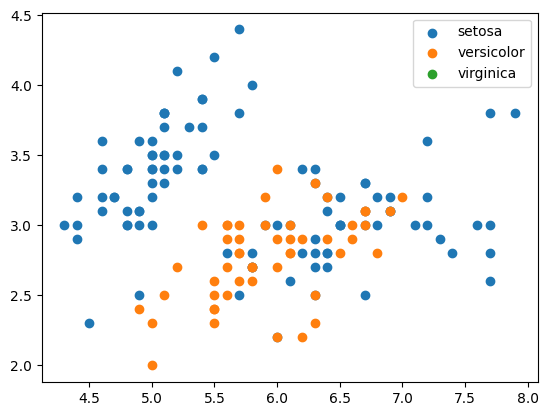
# setosaとvirginicaを1つにまとめて2クラスにする
y[y == 2] = 0
fig, ax = plt.subplots()
for c, label in enumerate(['setosa', 'versicolor', 'virginica']):
is_c = y == c
ax.scatter(X[is_c, 0], X[is_c, 1], label=label)
ax.legend()x1 = np.array([[1], [2]])
x2 = np.array([[3], [4]])
x1def rbf_kernel(x1, x2, sigma=1.0) -> float:
return - np.linalg.norm(x1 - x2)**2 / (2 * sigma**2)
rbf_kernel(x1, x2)
class GaussianKernel:

    def fit(self, X):
        self.alpha = 0.001
        self.mu = np.mean(X, axis=0)
        self.sigma = np.cov(X, rowvar=False, bias=False)

    def transform(self, X) -> np.array:
        return np.array([self._transform(x) for x in X])

    def _transform(self, x) -> float:
        return np.exp( - self.alpha * (x - self.mu) @ np.linalg.inv(self.sigma) @ (x - self.mu) )

    def __repr__(self) -> str:
        return f"<{self.__class__.__name__} alpha={self.alpha}, mu={self.mu}, sigma={self.sigma}>"