モデル
目的変数の二値分類において、である確率を、である確率をとする。
ロジスティック回帰(logistic regression) はの確率を表現するモデル
である。ここで は の入力を の範囲にする関数で、 (ロジスティック)シグモイド関数 という。
また、ロジスティック回帰はオッズ比の対数を線形モデルで説明するモデル
\renewcommand{\b} when command \b does not yet exist; use \newcommand

\renewcommand{\b}[1]{\boldsymbol{#1}}
\log\left( \frac{p}{1-p} \right) = \boldsymbol{\beta}^\top \boldsymbol{x}
ともいえる。
モデル表現の導出
前半部の導出
Undefined control sequence: \b at position 37: …}{1-p} &= \exp(\̲b̲{\beta}^\top \b…

\begin{align}
\frac{p}{1-p} &= \exp(\b{\beta}^\top \b{x})\\
\implies
p &= \exp(\b{\beta}^\top \b{x}) (1-p)\\
  &= \exp(\b{\beta}^\top \b{x}) - p \exp(\b{\beta}^\top \b{x})
\end{align}両辺をで割ると
Undefined control sequence: \b at position 26: …gn}
1  &= \exp(\̲b̲{\beta}^\top \b…

\begin{align}
1  &= \exp(\b{\beta}^\top \b{x}) \frac{1}{p} - \exp(\b{\beta}^\top \b{x})\\
1 + \exp(\b{\beta}^\top \b{x}) &= \exp(\b{\beta}^\top \b{x}) \frac{1}{p}\\
\implies p &= \frac{ \exp(\b{\beta}^\top \b{x}) }{ 1 + \exp(\b{\beta}^\top \b{x}) }
\end{align}ベルヌーイ分布
ロジスティック回帰はのベルヌーイ分布に従う。
この確率質量関数は一括で書くと
と書くことができる。
尤度関数
尤度関数とは一般に確率(密度/質量)関数の積
である(独立に得られたサンプルを仮定するので単純な積が同時確率を意味する)。
そのため、ベルヌーイ分布の尤度関数は
となる。
ロジスティック回帰で使う場合、はロジスティック回帰の予測値、は実測値である。
確率の積だとすごく小さい値になって計算が大変なので、通常は対数を取った対数尤度を使う。
交差エントロピー誤差
ベルヌーイ分布の対数尤度関数の符号を負に反転させたものを交差エントロピー誤差(cross entropy loss)という。log lossやlogistic lossとも呼ばれる
単に言葉の問題だが、統計学系の分野では「対数尤度の最大化(最尤推定法)」という言い方をして、機械学習では「交差エントロピー誤差(=負の対数尤度)の最小化」とか言う。やってることは同じ。
スクラッチ実装例
# 対数尤度
import numpy as np

def sigmoid(x):
    return 1 / (1 + np.exp(-x))

def log_likelihood(X, y, beta):
    p = sigmoid(X @ beta)
    c = 0.0001
    p = np.clip(p, a_min=c, a_max=1 - c) # log(p), log(1-p)でゼロをいれないようにする
    return np.sum(y * np.log(p) + (1 - y) * np.log(1 - p))
2次元の特徴量からなる、次のようなデータがあるとする
Source
from sklearn.datasets import make_blobs
import matplotlib.pyplot as plt

# データ生成
X, y = make_blobs(n_samples=300, n_features=2, centers=2, cluster_std=1.7, random_state=42)

# プロット
fig, ax = plt.subplots(figsize=(4, 3))
ax.scatter(X[y == 0, 0], X[y == 0, 1], s=20, label="y = 0")
ax.scatter(X[y == 1, 0], X[y == 1, 1], s=20, label="y = 1")
ax.legend()
ax.set(xlim=(X[:, 0].min()-1, X[:, 0].max()+1), ylim=(X[:, 1].min()-1, X[:, 1].max()+1))
ax.set(xlabel="x1", ylabel="x2")
plt.show()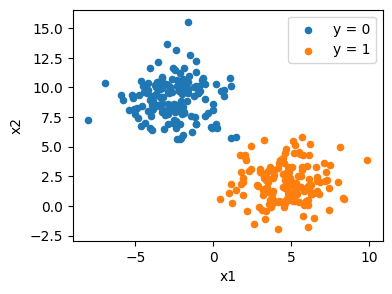
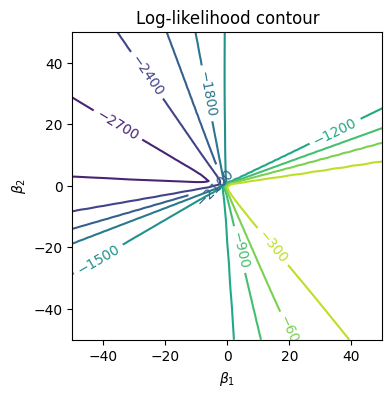
さまざまなの値のもとでの対数尤度を計算すると次のような等高線になる
Source
# 対数尤度のplot
import matplotlib.pyplot as plt

# --- βのグリッド ---
beta_range = np.linspace(-50, 50, 100)
B1, B2 = np.meshgrid(beta_range, beta_range)

# --- 尤度を格子上で計算 ---
LL = np.zeros_like(B1)
for i in range(B1.shape[0]):
    for j in range(B1.shape[1]):
        beta = np.array([B1[i, j], B2[i, j]])
        LL[i, j] = log_likelihood(X, y, beta)

# --- contour plot ---
fig, ax = plt.subplots(figsize=(4, 4))
cs = ax.contour(B1, B2, LL, levels=10)
ax.clabel(cs)
ax.set_xlabel(r"$\beta_1$")
ax.set_ylabel(r"$\beta_2$")
ax.set_title("Log-likelihood contour")
plt.show()
/tmp/ipykernel_40358/1805774186.py:5: RuntimeWarning: overflow encountered in exp
return 1 / (1 + np.exp(-x))
from scipy.optimize import minimize

beta0 = np.zeros(X.shape[1])
res = minimize(
    fun=lambda beta: -log_likelihood(X, y, beta), # minimizeの関数なので負にする
    x0=beta0,
    method="BFGS",
    options={"gtol": 1e-6, "maxiter": 1000},
)

beta_hat = res.x
print("success:", res.success)
print("message:", res.message)
print("beta_hat:", beta_hat)
print("max loglik:", -res.fun)
success: True
message: Optimization terminated successfully.
beta_hat: [ 41.07515312 -13.2522211 ]
max loglik: -0.0300015001000042
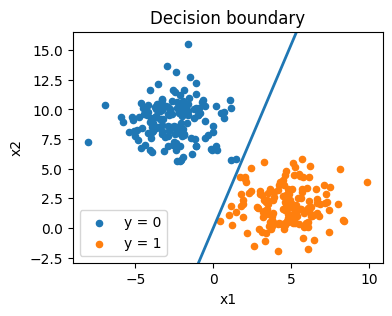
推定値での識別境界は次のようになる
Source
import numpy as np
import matplotlib.pyplot as plt
from sklearn.datasets import make_blobs

b1, b2 = beta_hat

# --- 散布図 ---
fig, ax = plt.subplots(figsize=(4, 3))
ax.scatter(X[y == 0, 0], X[y == 0, 1], s=20, label="y = 0")
ax.scatter(X[y == 1, 0], X[y == 1, 1], s=20, label="y = 1")
ax.legend()
ax.set(xlim=(X[:, 0].min()-1, X[:, 0].max()+1), ylim=(X[:, 1].min()-1, X[:, 1].max()+1))

# --- 識別境界 ---
x1 = np.linspace(X[:, 0].min(), X[:, 0].max(), 100)
eps = 1e-12
if abs(b2) > eps:
    # 切片なしモデルだと識別境界は b1*x1 + b2*x2 = 0 → x2 = - (b1/b2) * x1
    x2 = -(b1 / b2) * x1
    ax.plot(x1, x2, linewidth=2)
else:
    # β2 = 0 → 垂直線 β1 x1 = 0
    ax.axvline(0.0, linewidth=2)

ax.set(xlabel="x1", ylabel="x2", title="Decision boundary")
plt.show()
導出
総和を取るまえの1レコード単位のものを使う。
\renewcommand{\s} when command \s does not yet exist; use \newcommand

\renewcommand{\s}{ \sigma(\beta^\top x) }
\ell(\beta) = y \ln \s + (1 - y) \ln (1 - \s)\sに関する微分
Undefined control sequence: \s at position 27: …n}
\frac{d \ln \̲s̲}{d \beta}
&= \…

\begin{align}
\frac{d \ln \s}{d \beta}
&= \frac{d \ln \s}{d \s} \frac{d \s}{d (\beta^\top x)} \frac{d (\beta^\top x)}{d \beta}\\
&= \frac{1}{\s} \cdot \s (1 - \s) \cdot x\\
&= 1 - \s x
\\
\frac{d \ln (1 -\s)}{d \beta}
&= \frac{d \ln (1 -\s)}{d \s} \frac{d \s}{d (\beta^\top x)} \frac{d (\beta^\top x)}{d \beta}\\
&= -\frac{1}{1-\s} \cdot \s (1 - \s) \cdot x\\
&= - \s x
\end{align}
より、
Undefined control sequence: \s at position 54: …eta}
&= y (1 - \̲s̲)x - (1 - y) \s…

\begin{align}
\frac{d \ell(\beta)}{d\beta}
&= y (1 - \s)x - (1 - y) \s x\\
&= (y - y\s - \s + y\s) x\\
&= (y - \s ) x\\
\end{align}
(参考)使った微分
from sklearn.datasets import load_breast_cancer
X, y = load_breast_cancer(return_X_y=True)
にする場合
上記の例ではとしていた。とする場合は少し書き方が変わる
の確率との確率がそれぞれ
で表されるとする。のとき、これらを1つにまとめて、の確率を
と書くことができる。
尤度は
負の対数尤度は
と書くことができる。機械学習の分野だとこちらの表現のほうが目にするかも。