主成分分析は学習データの分散が最大になる方向への線形変換を求める手法。
D次元のデータx=(x1,⋯,xD)TがN個あるとする。i番目の観測値を行ベクトルxiとして表し、データを行列X=(x1,⋯,xN)Tと表す。
各変数の平均のベクトルxˉ=(xˉ1,...,xˉD)Tを引き算した行列をXˉ=(x1−xˉ,...,xN−xˉ)Tとおけば、共分散行列Σは
Σ=Var[Xˉ]=N1XˉTXˉ で定義される。
係数ベクトルaj=(aj1,...,ajD)T (j=1,...,D)を用いてXˉを線形変換したベクトルをsjとする。
sj=(s1j,...,sNj)T=Xˉaj このデータの分散は
Var[sj]=N1sjTsj=N1(Xˉaj)TXˉaj=N1ajTXˉTXˉaj=ajTVar[Xˉ]aj となる。
このままmaxajVar[sj]を解くと単にaj=∞が解になってしまうので、係数ベクトルajのノルム制約条件をかけた最大化問題を解くことにする。
この分散が最大となる射影ベクトルは、ラグランジュ関数
L(aj)=ajTVar[Xˉ]aj−λ(ajTaj−1) を最大にするajである。(λはラグランジュ未定乗数)
微分して0とおけば
∂aj∂L(aj)=2Var[Xˉ]aj−2λaj=0 より
Var[Xˉ]aj=λaj となる。
このλとajは固有値問題を解くことにより得られる。
計算例
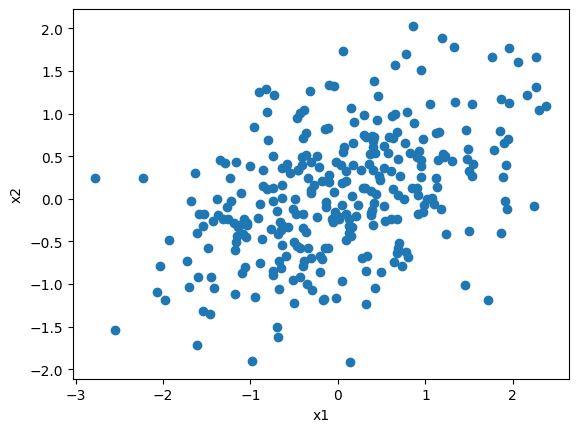
今回は次のデータを使って計算の例を示していく
import numpy as np
import matplotlib.pyplot as plt
from scipy.stats import norm

w = 0.3
n = 300
x1 = norm.rvs(loc=0, scale=1, size=n, random_state=0)
x2 = w * x1 + (1 - w) * norm.rvs(loc=0, scale=1, size=n, random_state=1)
X = np.append(x1.reshape(-1, 1), x2.reshape(-1, 1), axis=1)

fig, ax = plt.subplots()
ax.scatter(x1, x2)
ax.set(xlabel="x1", ylabel="x2")
fig.show()
データ行列X=(x1,...,xN)Tから平均ベクトルを引き算した行列をXˉ=(x1−xˉ,...,xN−xˉ)Tとおけば、共分散行列Σは
Σ=Var[Xˉ]=N1XˉTXˉ と推定できる
x_bar = X.mean(axis=0)
X_bar = X - x_bar
Sigma = (1 / n) * X_bar.T @ X_bar
Sigma
array([[1.00140312, 0.32999238],
       [0.32999238, 0.54438079]])
固有値分解
分散最大化問題の解は
Var[Xˉ]aj=λaj であったので、固有値問題を解いてλとajを推定していく。
lambdas, vectors = np.linalg.eig(Sigma)
print(f"""
λ={lambdas}
a1={vectors[:, 0].round(3)}
a2={vectors[:, 1].round(3)}
""")
λ=[1.17427995 0.37150396]
a1=[0.886 0.464]
a2=[-0.464  0.886]
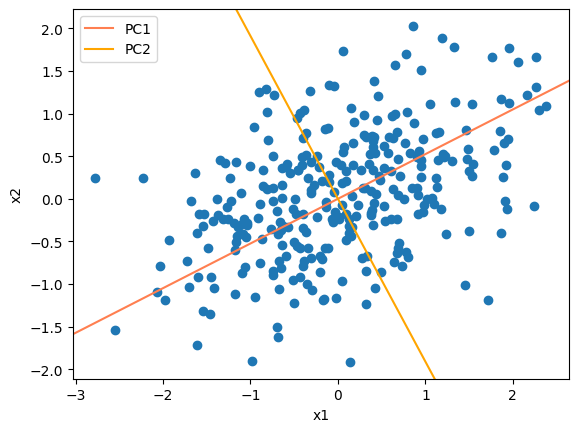
主成分を表す固有ベクトルの傾きに直線をプロットすると以下の通り。
fig, ax = plt.subplots()
ax.scatter(x1, x2)
ax.axline(xy1=(0, 0), xy2=(vectors[:, 0]), color="coral", label="PC1")
ax.axline(xy1=(0, 0), xy2=(vectors[:, 1]), color="orange", label="PC2")
ax.set(xlabel="x1", ylabel="x2")
ax.legend()
fig.show()
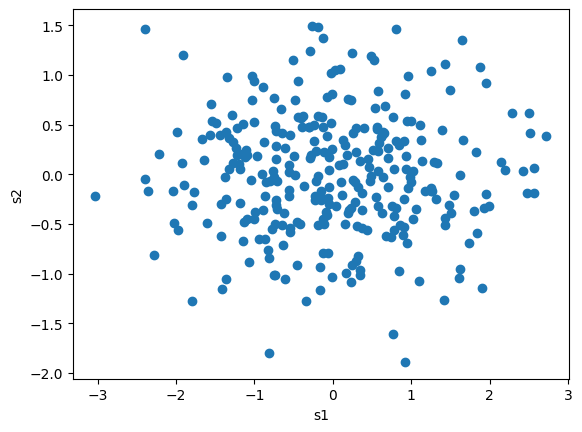
推定できたaの任意の次元数を使って線形変換s=Xˉaを作る
S = X_bar @ vectors

fig, ax = plt.subplots()
ax.scatter(S[:, 0], S[:, 1])
ax.set(xlabel="s1", ylabel="s2")
fig.show()
寄与率
次元削減を行う際は、元の分散を多く説明している(=固有値λjが大きい)次元を残すようにすればよい
array([1.17427995, 0.37150396])
# 寄与率:主成分の分散(固有値)の割合
lambdas / sum(lambdas)
array([0.7596663, 0.2403337])
from sklearn.decomposition import PCA
pca = PCA(n_components=2)
pca.fit(X)

# 寄与率:主成分の分散(固有値)の割合
pca.explained_variance_ratio_
array([0.7596663, 0.2403337])
array([[ 2.28345887,  0.61668615],
       [ 0.15906083, -0.49935839],
       [ 0.77927075, -0.56227195]])
array([[ 2.28345887,  0.61668615],
       [ 0.15906083, -0.49935839],
       [ 0.77927075, -0.56227195]])