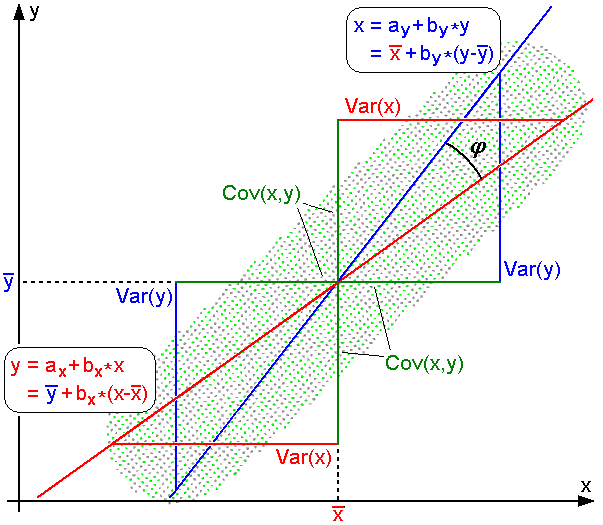
ピアソンの積率相関係数 ¶ r = Cov ( X , Y ) σ Y σ Y r = \frac{\operatorname{Cov}(X, Y)}{\sigma_{Y} \sigma_{Y} } r = σ Y σ Y Cov ( X , Y ) Cov ( X , Y ) \operatorname{Cov}(X, Y) Cov ( X , Y )
σ Y , σ Y \sigma_{Y}, \sigma_{Y} σ Y , σ Y
r ^ = ∑ ( x i − x ˉ ) ( y i − y ˉ ) ∑ ( x i − x ˉ ) 2 ∑ ( y i − y ˉ ) 2 \hat{r} = \frac{\sum\left(x_i-\bar{x}\right)\left(y_i-\bar{y}\right)}{\sqrt{\sum\left(x_i-\bar{x}\right)^2} \sqrt{\sum\left(y_i-\bar{y}\right)^2}} r ^ = ∑ ( x i − x ˉ ) 2 ∑ ( y i − y ˉ ) 2 ∑ ( x i − x ˉ ) ( y i − y ˉ ) どうやって[ − 1 , 1 ] [-1,1] [ − 1 , 1 ] ¶ 結論:コーシー・シュワルツの不等式を確率変数にあてはめている。
前提:内積 ¶ ベクトル空間(要素間の和と定数倍が定義された集合であり、和と定数倍の結果もまた集合の要素であるような集合)における内積について触れておく。
(参考)内積の定義
R \mathbb{R} R V V V a , b \boldsymbol{a}, \boldsymbol{b} a , b ⟨ a , b ⟩ \langle \boldsymbol{a}, \boldsymbol{b} \rangle ⟨ a , b ⟩ ⟨ a , b ⟩ \langle \boldsymbol{a}, \boldsymbol{b} \rangle ⟨ a , b ⟩ a \boldsymbol{a} a b \boldsymbol{b} b
(1) ⟨ a , b ⟩ = ⟨ b , a ⟩ \langle \boldsymbol{a}, \boldsymbol{b} \rangle = \langle \boldsymbol{b}, \boldsymbol{a} \rangle ⟨ a , b ⟩ = ⟨ b , a ⟩
(2) ⟨ a + b , c ⟩ = ⟨ a , c ⟩ + ⟨ b , c ⟩ \langle \boldsymbol{a} + \boldsymbol{b}, \boldsymbol{c} \rangle = \langle \boldsymbol{a}, \boldsymbol{c} \rangle + \langle \boldsymbol{b}, \boldsymbol{c} \rangle ⟨ a + b , c ⟩ = ⟨ a , c ⟩ + ⟨ b , c ⟩
(3) ⟨ k a , b ⟩ = k ⟨ a , b ⟩ ( k ∈ R ) \langle k \boldsymbol{a}, \boldsymbol{b} \rangle = k \langle \boldsymbol{a}, \boldsymbol{b} \rangle \quad (k \in \mathbb{R}) ⟨ k a , b ⟩ = k ⟨ a , b ⟩ ( k ∈ R )
(4) ⟨ a , a ⟩ ≧ 0 \langle \boldsymbol{a}, \boldsymbol{a} \rangle \geqq 0 ⟨ a , a ⟩ ≧ 0 ⟨ a , a ⟩ = 0 ⟺ a = 0 \langle \boldsymbol{a}, \boldsymbol{a} \rangle = 0 \Longleftrightarrow \boldsymbol{a} = \mathbf{0} ⟨ a , a ⟩ = 0 ⟺ a = 0
また、内積⟨ a , b ⟩ \langle \boldsymbol{a}, \boldsymbol{b} \rangle ⟨ a , b ⟩ ∥ a ∥ = ⟨ a , a ⟩ \|\boldsymbol{a}\| = \sqrt{\langle \boldsymbol{a}, \boldsymbol{a} \rangle} ∥ a ∥ = ⟨ a , a ⟩ コーシー・シュワルツの不等式
∣ ⟨ a , b ⟩ ∣ ≤ ∥ a ∥ ⋅ ∥ b ∥ ⟺ − ∥ a ∥ ⋅ ∥ b ∥ ≤ ⟨ a , b ⟩ ≤ ∥ a ∥ ⋅ ∥ b ∥ ⟺ − 1 ≤ ⟨ a , b ⟩ ∥ a ∥ ⋅ ∥ b ∥ ≤ 1 \begin{aligned}
& | \langle \boldsymbol{a}, \boldsymbol{b} \rangle |
\leq
\| \boldsymbol{a} \| \cdot \| \boldsymbol{b} \|
\\
\iff &
- \| \boldsymbol{a} \| \cdot \| \boldsymbol{b} \|
\leq
\langle \boldsymbol{a}, \boldsymbol{b} \rangle
\leq
\| \boldsymbol{a} \| \cdot \| \boldsymbol{b} \|
\\
\iff &
- 1 \leq
\frac{\langle \boldsymbol{a}, \boldsymbol{b} \rangle}{\| \boldsymbol{a} \| \cdot \| \boldsymbol{b} \|}
\leq 1
\end{aligned} ⟺ ⟺ ∣ ⟨ a , b ⟩ ∣ ≤ ∥ a ∥ ⋅ ∥ b ∥ − ∥ a ∥ ⋅ ∥ b ∥ ≤ ⟨ a , b ⟩ ≤ ∥ a ∥ ⋅ ∥ b ∥ − 1 ≤ ∥ a ∥ ⋅ ∥ b ∥ ⟨ a , b ⟩ ≤ 1 というものが存在する。
なお、⟨ a , b ⟩ ∥ a ∥ ⋅ ∥ b ∥ \frac{\langle \boldsymbol{a}, \boldsymbol{b} \rangle}{\| \boldsymbol{a} \| \cdot \| \boldsymbol{b} \|} ∥ a ∥ ⋅ ∥ b ∥ ⟨ a , b ⟩ コサイン類似度 と呼ばれ、ベクトル間の類似性を示すのでデータサイエンスの世界でよく使われる。
具体的な内積の例 ¶ 実数空間R \mathbb{R} R x , y ∈ R n \boldsymbol{x},\boldsymbol{y}\in \mathbb{R}^n x , y ∈ R n
⟨ x , y ⟩ = ∑ i = 1 n x i y i \langle \boldsymbol{x}, \boldsymbol{y} \rangle = \sum_{i=1}^n x_i y_i ⟨ x , y ⟩ = i = 1 ∑ n x i y i 標本レベルの話 ¶ n n n x = ( x 1 , x 2 , ⋯ , x n ) ⊤ \boldsymbol{x} = (x_1, x_2, \cdots, x_n)^\top x = ( x 1 , x 2 , ⋯ , x n ) ⊤ y = ( y 1 , y 2 , ⋯ , y n ) ⊤ \boldsymbol{y} = (y_1, y_2, \cdots, y_n)^\top y = ( y 1 , y 2 , ⋯ , y n ) ⊤
またそれらから平均値x ˉ , y ˉ \bar{x}, \bar{y} x ˉ , y ˉ x ˉ = ( x 1 − x ˉ , x 2 − x ˉ , ⋯ , x n − x ˉ ) ⊤ \bar{\boldsymbol{x}} = (x_1 - \bar{x}, x_2 - \bar{x}, \cdots, x_n - \bar{x})^\top x ˉ = ( x 1 − x ˉ , x 2 − x ˉ , ⋯ , x n − x ˉ ) ⊤ y ˉ = ( y 1 − y ˉ , y 2 − y ˉ , ⋯ , y n − y ˉ ) ⊤ \bar{\boldsymbol{y}} = (y_1 - \bar{y}, y_2 - \bar{y}, \cdots, y_n - \bar{y})^\top y ˉ = ( y 1 − y ˉ , y 2 − y ˉ , ⋯ , y n − y ˉ ) ⊤
標本共分散Cov ^ \widehat{\operatorname{Cov}} Cov
Cov ^ = 1 N ∑ i = 1 n ( x i − x ˉ ) ( y i − y ˉ ) = 1 N ⟨ x ˉ , y ˉ ⟩ \widehat{\operatorname{Cov}}
= \frac{1}{N} \sum_{i=1}^n (x_i - \bar{x}) (y_i - \bar{y})
= \frac{1}{N} \langle \bar{\boldsymbol{x}}, \bar{\boldsymbol{y}} \rangle Cov = N 1 i = 1 ∑ n ( x i − x ˉ ) ( y i − y ˉ ) = N 1 ⟨ x ˉ , y ˉ ⟩ x , y \boldsymbol{x}, \boldsymbol{y} x , y
σ ^ x = 1 N ∑ i = 1 n ( x i − x ˉ ) 2 = 1 N ∑ i = 1 n x ˉ 2 = 1 N ⟨ x ˉ , x ˉ ⟩ σ ^ y = 1 N ∑ i = 1 n ( y i − y ˉ ) 2 = 1 N ∑ i = 1 n y ˉ 2 = 1 N ⟨ y ˉ , y ˉ ⟩ \begin{aligned}
\hat{\sigma}_{\boldsymbol{x}}
&= \sqrt{ \frac{1}{N} \sum_{i=1}^n (x_i - \bar{x})^2 }
= \sqrt{ \frac{1}{N} \sum_{i=1}^n \bar{\boldsymbol{x}}^2 }
= \sqrt{ \frac{1}{N} \langle \bar{\boldsymbol{x}}, \bar{\boldsymbol{x}} \rangle }
\\
\hat{\sigma}_{\boldsymbol{y}}
&= \sqrt{ \frac{1}{N} \sum_{i=1}^n (y_i - \bar{y})^2 }
= \sqrt{ \frac{1}{N} \sum_{i=1}^n \bar{\boldsymbol{y}}^2 }
= \sqrt{ \frac{1}{N} \langle \bar{\boldsymbol{y}}, \bar{\boldsymbol{y}} \rangle }
\end{aligned} σ ^ x σ ^ y = N 1 i = 1 ∑ n ( x i − x ˉ ) 2 = N 1 i = 1 ∑ n x ˉ 2 = N 1 ⟨ x ˉ , x ˉ ⟩ = N 1 i = 1 ∑ n ( y i − y ˉ ) 2 = N 1 i = 1 ∑ n y ˉ 2 = N 1 ⟨ y ˉ , y ˉ ⟩ よって
r ^ = Cov ^ σ ^ x σ ^ y = 1 N ⟨ x ˉ , y ˉ ⟩ 1 N ⟨ x ˉ , x ˉ ⟩ 1 N ⟨ y ˉ , y ˉ ⟩ = ⟨ x ˉ , y ˉ ⟩ ∥ x ˉ ∥ ⋅ ∥ y ˉ ∥ \hat{r}
= \frac{\widehat{\operatorname{Cov}}}{\hat{\sigma}_{\boldsymbol{x}}\hat{\sigma}_{\boldsymbol{y}}}
= \frac{\frac{1}{N} \langle \bar{\boldsymbol{x}}, \bar{\boldsymbol{y}} \rangle}{
\sqrt{ \frac{1}{N} \langle \bar{\boldsymbol{x}}, \bar{\boldsymbol{x}} \rangle }
\sqrt{ \frac{1}{N} \langle \bar{\boldsymbol{y}}, \bar{\boldsymbol{y}} \rangle }
}
= \frac{ \langle \bar{\boldsymbol{x}}, \bar{\boldsymbol{y}} \rangle }
{ \| \bar{\boldsymbol{x}} \| \cdot \| \bar{\boldsymbol{y}} \| } r ^ = σ ^ x σ ^ y Cov = N 1 ⟨ x ˉ , x ˉ ⟩ N 1 ⟨ y ˉ , y ˉ ⟩ N 1 ⟨ x ˉ , y ˉ ⟩ = ∥ x ˉ ∥ ⋅ ∥ y ˉ ∥ ⟨ x ˉ , y ˉ ⟩ したがってコーシー・シュワルツの定理
− 1 ≤ ⟨ a , b ⟩ ∥ a ∥ ⋅ ∥ b ∥ ≤ 1 -1 \leq
\frac{\langle \boldsymbol{a}, \boldsymbol{b} \rangle}{\| \boldsymbol{a} \| \cdot \| \boldsymbol{b} \|}
\leq 1 − 1 ≤ ∥ a ∥ ⋅ ∥ b ∥ ⟨ a , b ⟩ ≤ 1 より、相関係数の範囲は[ − 1 , 1 ] [-1,1] [ − 1 , 1 ]
期待値と内積 ¶ つづいて母集団レベルの話。
確率変数X , Y X,Y X , Y L 2 L^2 L 2 E [ X Y ] E[XY] E [ X Y ]
(1) ⟨ X , Y ⟩ = E [ X Y ] = E [ Y X ] = ⟨ Y , X ⟩ \langle X, Y \rangle = E[XY] = E[YX] = \langle Y, X \rangle ⟨ X , Y ⟩ = E [ X Y ] = E [ Y X ] = ⟨ Y , X ⟩
(2) ⟨ X + Y , Z ⟩ = ⟨ X , Z ⟩ + ⟨ Y , Z ⟩ \langle X + Y, Z \rangle = \langle X, Z \rangle + \langle Y, Z \rangle ⟨ X + Y , Z ⟩ = ⟨ X , Z ⟩ + ⟨ Y , Z ⟩
(3) ⟨ k X , Y ⟩ = k ⟨ X , Y ⟩ ( k ∈ R ) \langle k X, Y \rangle = k \langle X, Y \rangle \quad (k \in \mathbb{R}) ⟨ k X , Y ⟩ = k ⟨ X , Y ⟩ ( k ∈ R )
(4) ⟨ X , X ⟩ = E [ X 2 ] ≧ 0 \langle X, X \rangle = E[X^2] \geqq 0 ⟨ X , X ⟩ = E [ X 2 ] ≧ 0 E [ X 2 ] = 0 ⟺ X = 0 a.s. E[X^2] = 0 \iff X = 0 ~ \text{a.s.} E [ X 2 ] = 0 ⟺ X = 0 a.s.
相関係数の導出 ¶ コーシー・シュワルツの不等式の内積⟨ a , b ⟩ \langle \boldsymbol{a}, \boldsymbol{b} \rangle ⟨ a , b ⟩ A , B A,B A , B E [ A B ] E[A B] E [ A B ] X X X ∥ X ∥ = ⟨ X , X ⟩ = E [ X 2 ] \|X\| = \sqrt{\langle X, X \rangle} = E[X^2] ∥ X ∥ = ⟨ X , X ⟩ = E [ X 2 ]
∣ E [ A B ] ∣ 2 ≤ E [ A 2 ] E [ B 2 ] |E[A B]|^2 \leq E[A^2] E[B^2] ∣ E [ A B ] ∣ 2 ≤ E [ A 2 ] E [ B 2 ] を用いる。
A = ( X − E [ X ] ) , B = ( Y − E [ Y ] ) A = (X - E[X]),\quad
B = (Y - E[Y]) A = ( X − E [ X ]) , B = ( Y − E [ Y ]) とおくと
∣ E [ ( X − E [ X ] ) ( Y − E [ Y ] ) ] ∣ 2 ≤ E [ ( X − E [ X ] ) 2 ] E [ ( Y − E [ Y ] ) 2 ] ⟺ ∣ Cov ( X , Y ) ∣ 2 ≤ Var ( X ) Var ( Y ) ⟺ − 1 ≤ Cov ( X , Y ) Var ( X ) Var ( Y ) ≤ 1 \begin{aligned}
\big| E\big[ (X - E[X]) (Y - E[Y]) \big] \big|^2
\leq E[(X - E[X])^2] E[(Y - E[Y])^2]\\
\iff
| \operatorname{Cov}(X, Y) |^2
\leq \operatorname{Var}(X) \operatorname{Var}(Y)
\\
\iff
-1 \leq
\frac{ \operatorname{Cov}(X, Y) }{ \sqrt{ \operatorname{Var}(X) } \sqrt{ \operatorname{Var}(Y) } }
\leq 1
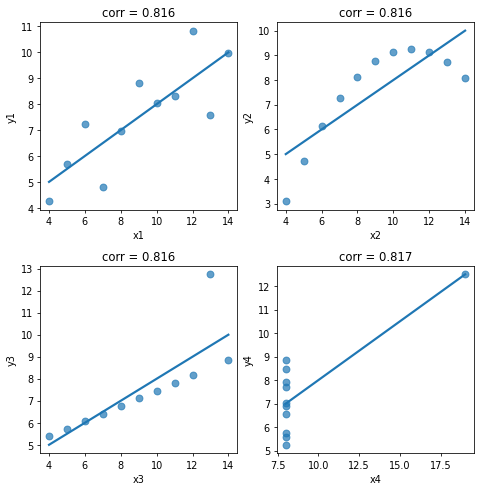
\end{aligned} ∣ ∣ E [ ( X − E [ X ]) ( Y − E [ Y ]) ] ∣ ∣ 2 ≤ E [( X − E [ X ] ) 2 ] E [( Y − E [ Y ] ) 2 ] ⟺ ∣ Cov ( X , Y ) ∣ 2 ≤ Var ( X ) Var ( Y ) ⟺ − 1 ≤ Var ( X ) Var ( Y ) Cov ( X , Y ) ≤ 1 注意点 ¶ データの関係性をざっくり表すのが相関係数の良さだが、散布図でみると全然異なるデータであってもたまたま同じ相関係数になることがある。また外れ値にひっぱられる特性もある。
下の図はアンスコムの例と呼ばれる、線形回帰をしたときに同じ傾き係数になるデータセット。
相関係数だと線形回帰と違って切片部分がないため係数は若干異なるがだいたい同じになる。
import statsmodels.api as sm
import pandas as pd
anscombe = sm.datasets.get_rdataset("anscombe").data

import matplotlib.pyplot as plt
import seaborn as sns
fig, axes = plt.subplots(ncols=2, nrows=2, figsize=[8,8], dpi=70)
axes = axes.flatten()
fig.subplots_adjust(hspace=0.3)
for i in range(4):
    corr = anscombe.filter(regex=f"{i+1}").corr().iloc[0,1]
    sns.regplot(data=anscombe, x=f"x{i+1}", y=f"y{i+1}", ax=axes[i],
                ci=None, scatter_kws={"s": 50, "alpha": 0.7})
    axes[i].set(title=f"corr = {corr:.3f}")
A New Coefficient of Correlation ¶ Chatterjee (2021) は 以下の3つの性質をもつ相関係数が定義可能かという問いを立て、これらを満たす新たな相関係数を提案した。
シンプル:ピアソンなど古典的な相関係数のように計算が簡単であること
一貫性:相関係数が0となるのは変数が独立な場合のみで、1となるのは一方が他方の可測関数である場合のみであること。
漸近理論:古典的な相関係数のように簡潔な漸近理論をもつ
この新しい相関係数は、変数の分布に関する仮定を必要とせず、非線形な依存関係も捉えることができる。
また、独立性の検定や変数間の関係性の評価において、従来の相関係数よりも優れた性能を示すことが報告されている
ξ n ( X , Y ) : = 1 − 3 ∑ i = 1 n − 1 ∣ r i + 1 − r i ∣ n 2 − 1 \xi_n(X, Y):=1-\frac{3 \sum_{i=1}^{n-1}\left|r_{i+1}-r_i\right|}{n^2-1} ξ n ( X , Y ) := 1 − n 2 − 1 3 ∑ i = 1 n − 1 ∣ r i + 1 − r i ∣
Chatterjee, S. (2020). A New Coefficient of Correlation. Journal of the American Statistical Association , 116 (536), 2009–2022. 10.1080/01621459.2020.1758115