モデル ¶ リッジ回帰 (ridge regression)は誤差関数に正則化項を追加した線形回帰モデルである。
モデル自体は線形回帰と同様で目的変数y y y β = ( β 1 , β 2 , . . . , β d ) ⊤ \boldsymbol{\beta}=(\beta_1, \beta_2, ..., \beta_d)^\top β = ( β 1 , β 2 , ... , β d ) ⊤ x = ( x 1 , x 2 , . . . , x d ) ⊤ \boldsymbol{x}=(x_1, x_2, ..., x_d)^\top x = ( x 1 , x 2 , ... , x d ) ⊤ ε \varepsilon ε
y = β 0 + β 1 x 1 + ⋯ + β d x d + ε y = \beta_0 + \beta_1 x_1 + \cdots + \beta_d x_d + \varepsilon y = β 0 + β 1 x 1 + ⋯ + β d x d + ε サンプルサイズがn n n { x i , y i } i = 1 n \{\boldsymbol{x}_i, y_i\}^n_{i=1} { x i , y i } i = 1 n y = ( y 1 , y 2 , . . . , y n ) ⊤ \boldsymbol{y} = (y_1, y_2, ..., y_n)^\top y = ( y 1 , y 2 , ... , y n ) ⊤ X = ( x 1 , x 2 , . . . , x n ) ⊤ \boldsymbol{X}=(\boldsymbol{x}_1, \boldsymbol{x}_2, ..., \boldsymbol{x}_n)^\top X = ( x 1 , x 2 , ... , x n ) ⊤
y = X β + ε \boldsymbol{y}=\boldsymbol{X} \boldsymbol{\beta}+\boldsymbol{\varepsilon} y = X β + ε と表記することもできる。
パラメータの推定 ¶ 制約付き最小化問題 ¶ リッジ回帰が線形回帰と違う点は、パラメータの推定(誤差関数の最小化)に関して制約条件があること。
線形回帰は目的変数の実測値y i y_i y i y ^ i = ∑ j = 1 d x i j β j \hat{y}_i=\sum^d_{j=1} x_{ij} \beta_j y ^ i = ∑ j = 1 d x ij β j S S E = ∑ i = 1 n ( y i − y ^ i ) 2 SSE=\sum^n_{i=1} (y_i - \hat{y}_i)^2 SSE = ∑ i = 1 n ( y i − y ^ i ) 2
β ^ LS = a r g m i n β ∑ i = 1 n ( y i − y ^ i ) 2 \renewcommand{\argmin}{\mathop{\rm arg~min}\limits}
\hat{\boldsymbol{\beta}}^{\text{LS}} = \argmin_{\boldsymbol{\beta}}
\sum^n_{i=1} (y_i - \hat{y}_i)^2 β ^ LS = β arg min i = 1 ∑ n ( y i − y ^ i ) 2 リッジ回帰はこれに「パラメータβ j \beta_j β j R R R
β ^ Ridge = a r g m i n β ∑ i = 1 n ( y i − y ^ i ) 2 subject to ∑ i = 1 d β j 2 ≤ R \renewcommand{\argmin}{\mathop{\rm arg~min}\limits}
\begin{align}
\hat{\boldsymbol{\beta}}^{\text{Ridge}} = \text{ }
& \argmin_{\boldsymbol{\beta}} \sum^n_{i=1} (y_i - \hat{y}_i)^2
\\
& \text{subject to } \sum^d_{i=1} \beta_j^2 \leq R
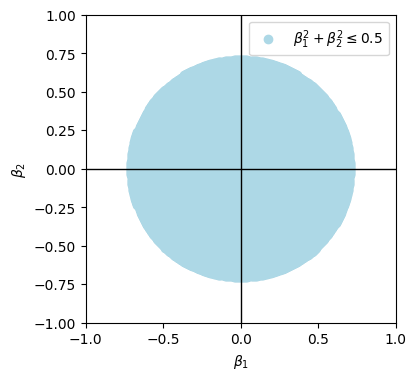
\end{align} β ^ Ridge = β arg min i = 1 ∑ n ( y i − y ^ i ) 2 subject to i = 1 ∑ d β j 2 ≤ R この制約条件は円の方程式と呼ばれるもので、2次元で描くと円の形になる。円の範囲内で誤差を最小化するパラメータを選ぶという条件付き最適化問題を解くことになる。
この問題を解くために、ラグランジュの未定乗数法 を利用する。
# 二乗和が円になるイメージ
import numpy as np
import matplotlib.pyplot as plt
import itertools

R = 0.5
b1 = np.linspace(-1, 1, 300)
b2 = np.linspace(-1, 1, 300)
b = np.array(list(itertools.product(b1, b2)))
is_in_R = (b[:, 0]**2 + b[:, 1]**2) <= R

fig, ax = plt.subplots(figsize=[4, 4])
ax.scatter(b[is_in_R, 0], b[is_in_R, 1], color="lightblue", label=r"$\beta_1^2 + \beta_2^2 \leq 0.5$")
ax.axvline(color="black", linewidth=1)
ax.axhline(color="black", linewidth=1)
ax.set(xlabel=r"$\beta_1$", ylabel=r"$\beta_2$", xlim=(-1,1), ylim=(-1,1))
ax.legend()
fig.show()誤差関数の整理 ¶ ラグランジュの未定乗数法を利用して、誤差関数を以下のように書くことができる。
J ( β ) = ∑ i = 1 n ( y i − y ^ i ) 2 + λ ∑ j = 1 d β j 2 J({\boldsymbol{\beta}})
= \sum_{i=1}^n(y_i - \hat{y}_i)^2 + \lambda \sum_{j=1}^d \beta_j^2 J ( β ) = i = 1 ∑ n ( y i − y ^ i ) 2 + λ j = 1 ∑ d β j 2 この右辺第二項は正則化項 、λ \lambda λ 正則化パラメータ と呼ばれる。λ = 0 \lambda=0 λ = 0
一般的なラグランジュ双対問題とは異なり、リッジ回帰では最適なλ \lambda λ λ \lambda λ x x x λ \lambda λ
また、最初の制約問題で登場したR R R β \beta β R R R
ちなみに行列表記するとこんな感じに表される。
J ( β ) = ∑ i = 1 n ( y i − y ^ i ) 2 + λ ∑ j = 1 d β j 2 = ∥ y − X β ∥ 2 2 + λ ∥ β ∥ 2 2 = ( y − X β ) ⊤ ( y − X β ) + λ β ⊤ β \begin{align}
J({\boldsymbol{\beta}})
&= \sum_{i=1}^n(y_i - \hat{y}_i)^2 + \lambda \sum_{j=1}^d \beta_j^2
\\
&= \| \boldsymbol{y}-\boldsymbol{X}\boldsymbol{\beta}\|^2_2
+ \lambda\| \boldsymbol{\beta}\|^2_2
\\
&= (\boldsymbol{y}-\boldsymbol{X}\boldsymbol{\beta})^\top
(\boldsymbol{y}-\boldsymbol{X}\boldsymbol{\beta})
+ \lambda \boldsymbol{\beta}^\top \boldsymbol{\beta}
\end{align} J ( β ) = i = 1 ∑ n ( y i − y ^ i ) 2 + λ j = 1 ∑ d β j 2 = ∥ y − X β ∥ 2 2 + λ ∥ β ∥ 2 2 = ( y − X β ) ⊤ ( y − X β ) + λ β ⊤ β リッジ回帰の推定量β ^ Ridge \hat{\boldsymbol{\beta}}^{\text{Ridge}} β ^ Ridge
J ( β ) = ( y − X β ) ⊤ ( y − X β ) + λ β ⊤ β = y ⊤ y − y ⊤ X β − ( X β ) ⊤ y + ( X β ) ⊤ ( X β ) + λ β ⊤ β = y ⊤ y − 2 β ⊤ X ⊤ y + β ⊤ X ⊤ X β + λ β ⊤ β \begin{align}
J(\boldsymbol{\beta})
&= (\boldsymbol{y}-\boldsymbol{X}\boldsymbol{\beta})^\top
(\boldsymbol{y}-\boldsymbol{X}\boldsymbol{\beta})
+ \lambda \boldsymbol{\beta}^\top \boldsymbol{\beta}
\\
&= \boldsymbol{y}^\top \boldsymbol{y}
- \boldsymbol{y}^\top \boldsymbol{X}\boldsymbol{\beta}
- (\boldsymbol{X}\boldsymbol{\beta})^\top \boldsymbol{y}
+ (\boldsymbol{X}\boldsymbol{\beta})^\top
(\boldsymbol{X}\boldsymbol{\beta})
+ \lambda \boldsymbol{\beta}^\top \boldsymbol{\beta}
\\
&= \boldsymbol{y}^\top \boldsymbol{y}
- 2 \boldsymbol{\beta}^\top \boldsymbol{X}^\top \boldsymbol{y}
+ \boldsymbol{\beta}^\top \boldsymbol{X}^\top
\boldsymbol{X} \boldsymbol{\beta}
+ \lambda \boldsymbol{\beta}^\top \boldsymbol{\beta}
\end{align} J ( β ) = ( y − X β ) ⊤ ( y − X β ) + λ β ⊤ β = y ⊤ y − y ⊤ X β − ( X β ) ⊤ y + ( X β ) ⊤ ( X β ) + λ β ⊤ β = y ⊤ y − 2 β ⊤ X ⊤ y + β ⊤ X ⊤ X β + λ β ⊤ β なので、誤差関数の傾きがゼロ(誤差が最小値)の点を求めると
∂ J ( β ) ∂ β = − 2 X ⊤ y + 2 ( X ⊤ X ) β + 2 λ β = 0 ⟹ ( X ⊤ X ) β + λ β = X ⊤ y ⟹ ( X ⊤ X + λ I ) β = X ⊤ y \frac{\partial J(\boldsymbol{\beta})}{\partial \boldsymbol{\beta}}
= -2\boldsymbol{X}^\top\boldsymbol{y}
+ 2(\boldsymbol{X}^\top\boldsymbol{X})\boldsymbol{\beta}
+ 2\lambda\boldsymbol{\beta}
=\boldsymbol{0}
\\
\Longrightarrow
(\boldsymbol{X}^\top\boldsymbol{X})\boldsymbol{\beta}
+ \lambda\boldsymbol{\beta}
=\boldsymbol{X}^\top\boldsymbol{y}
\\
\Longrightarrow
(\boldsymbol{X}^\top\boldsymbol{X} + \lambda \boldsymbol{I})\boldsymbol{\beta}
=\boldsymbol{X}^\top\boldsymbol{y} ∂ β ∂ J ( β ) = − 2 X ⊤ y + 2 ( X ⊤ X ) β + 2 λ β = 0 ⟹ ( X ⊤ X ) β + λ β = X ⊤ y ⟹ ( X ⊤ X + λ I ) β = X ⊤ y となり、
β ^ Ridge = ( X ⊤ X + λ I ) − 1 X ⊤ y \hat{\boldsymbol{\beta}}^{\text{Ridge}}
= (\boldsymbol{X}^\top \boldsymbol{X} + \lambda \boldsymbol{I})^{-1}
\boldsymbol{X}^\top \boldsymbol{y} β ^ Ridge = ( X ⊤ X + λ I ) − 1 X ⊤ y となる。
リッジ回帰の特徴 ¶ リッジ回帰は制約をかけたことにより通常の線形回帰(最小二乗法)とは異なる特徴をもっている。
正則化 ¶ 線形回帰の最小二乗推定量β ^ LS \hat{\boldsymbol{\beta}}^{\text{LS}} β ^ LS
β ^ LS = ( X ⊤ X ) − 1 X ⊤ y \hat{\boldsymbol{\beta}}^{\text{LS}}
= (\boldsymbol{X}^\top \boldsymbol{X})^{-1}
\boldsymbol{X}^\top \boldsymbol{y} β ^ LS = ( X ⊤ X ) − 1 X ⊤ y このとき、
X \boldsymbol{X} X
特徴量間の相関が非常に強い
といった状況においては、X ⊤ X \boldsymbol{X}^\top \boldsymbol{X} X ⊤ X
そこでリッジ回帰の推定量β ^ Ridge \hat{\boldsymbol{\beta}}^{\text{Ridge}} β ^ Ridge
β ^ Ridge = ( X ⊤ X + λ I ) − 1 X ⊤ y \hat{\boldsymbol{\beta}}^{\text{Ridge}}
= (\boldsymbol{X}^\top \boldsymbol{X} + \lambda \boldsymbol{I})^{-1}
\boldsymbol{X}^\top \boldsymbol{y} β ^ Ridge = ( X ⊤ X + λ I ) − 1 X ⊤ y と、X ⊤ X \boldsymbol{X}^\top \boldsymbol{X} X ⊤ X λ \lambda λ
X X X n n n X ⊤ X X^\top X X ⊤ X
X ⊤ X = P Γ P ⊤ X^\top X = P \Gamma P^\top X ⊤ X = P Γ P ⊤ と分解可能。ここでP P P Γ = d i a g ( γ 1 , ⋯ , γ n ) \Gamma = \mathrm{diag}(\gamma_1, \cdots, \gamma_n) Γ = diag ( γ 1 , ⋯ , γ n ) X ⊤ X X^\top X X ⊤ X γ 1 ≥ ⋯ ≥ γ n ≥ 0 \gamma_1 \geq \cdots \geq \gamma_n \geq 0 γ 1 ≥ ⋯ ≥ γ n ≥ 0
もしγ n = 0 \gamma_n = 0 γ n = 0 X ⊤ X X^\top X X ⊤ X γ n > 0 \gamma_n > 0 γ n > 0
( X ⊤ X ) − 1 = ( P Γ P ⊤ ) − 1 = P Γ − 1 P ⊤ ( ∵ ( A B C ) − 1 = ( C − 1 B − 1 A − 1 ) であり、 P は直交行列なので P ⊤ = P − 1 ) = P diag ( 1 / γ 1 , … , 1 / γ n ) P ⊤ \begin{aligned}
(X^\top X)^{-1}
&= (P \Gamma P^\top)^{-1}\\
&= P \Gamma^{-1} P^\top \quad (\because (ABC)^{-1} = (C^{-1} B^{-1} A^{-1}) であり、 Pは直交行列なのでP^\top = P^{-1})\\
&= P \operatorname{diag}(1 / \gamma_1, \ldots, 1 / \gamma_n) P^\top
\end{aligned} ( X ⊤ X ) − 1 = ( P Γ P ⊤ ) − 1 = P Γ − 1 P ⊤ ( ∵ ( A BC ) − 1 = ( C − 1 B − 1 A − 1 ) であり、 P は直交行列なので P ⊤ = P − 1 ) = P diag ( 1/ γ 1 , … , 1/ γ n ) P ⊤ となる。X ⊤ X X^\top X X ⊤ X γ n → 0 \gamma_n \to 0 γ n → 0 1 / γ n → ∞ 1/\gamma_n \to \infty 1/ γ n → ∞
一方、リッジ推定量のようにX ⊤ X + λ I X^\top X + \lambda I X ⊤ X + λ I λ ∈ R \lambda \in\mathbb{R} λ ∈ R
( X ⊤ X + λ I ) − 1 = ( P Γ P ⊤ + λ I ) − 1 = { P ( Γ + λ I ) P ⊤ } − 1 = P ( Γ + λ I ) − 1 P ⊤ = P diag [ 1 / ( γ 1 + λ I ) , … , 1 / ( γ n + λ I ) ] P ⊤ \begin{aligned}
(X^\top X + \lambda I)^{-1}
&= (P \Gamma P^\top + \lambda I)^{-1}\\
&= \{ P (\Gamma + \lambda I) P^\top \}^{-1}\\
&= P (\Gamma + \lambda I)^{-1} P^\top\\
&= P \operatorname{diag}[1 / (\gamma_1 + \lambda I), \ldots, 1 / (\gamma_n + \lambda I)] P^\top
\end{aligned} ( X ⊤ X + λ I ) − 1 = ( P Γ P ⊤ + λ I ) − 1 = { P ( Γ + λ I ) P ⊤ } − 1 = P ( Γ + λ I ) − 1 P ⊤ = P diag [ 1/ ( γ 1 + λ I ) , … , 1/ ( γ n + λ I )] P ⊤ となる。こちらはγ n → 0 \gamma_n \to 0 γ n → 0 1 / ( γ p + λ I ) 1 / (\gamma_p + \lambda I) 1/ ( γ p + λ I ) X ⊤ X + λ I X^\top X + \lambda I X ⊤ X + λ I
過学習の抑制 ¶ リッジ回帰の誤差関数
J ( β ) = ∑ i = 1 n ( y i − y ^ i ) 2 + λ ∑ j = 1 d β j 2 J(\beta)=
\sum_{i=1}^n(y_i - \hat{y}_i)^2 + \lambda \sum_{j=1}^d \beta_j^2 J ( β ) = i = 1 ∑ n ( y i − y ^ i ) 2 + λ j = 1 ∑ d β j 2 は、λ \lambda λ β j \beta_j β j
パラメータが学習データに過学習して大きい値になっているような状況ではパラメータをうまく縮小させることによって過学習を抑制してモデルの汎化誤差を下げることができる。
OLS推定量との関係 ¶ A : = X ⊤ X \boldsymbol{A}:=\boldsymbol{X}^\top \boldsymbol{X} A := X ⊤ X
β ^ Ridge = ( X ⊤ X + λ I ) − 1 X ⊤ y = ( A + λ I ) − 1 X ⊤ y \begin{aligned}
\hat{\boldsymbol{\beta}}^{\text{Ridge}}
&= (\boldsymbol{X}^\top \boldsymbol{X} + \lambda \boldsymbol{I})^{-1}
\boldsymbol{X}^\top \boldsymbol{y}\\
&= (\boldsymbol{A} + \lambda \boldsymbol{I})^{-1}
\boldsymbol{X}^\top \boldsymbol{y}\\
\end{aligned} β ^ Ridge = ( X ⊤ X + λ I ) − 1 X ⊤ y = ( A + λ I ) − 1 X ⊤ y となる。このとき
A + λ I = A ( I + λ A − 1 ) \boldsymbol{A} + \lambda \boldsymbol{I}
= \boldsymbol{A} (\boldsymbol{I} + \lambda \boldsymbol{A}^{-1}) A + λ I = A ( I + λ A − 1 ) であり、この逆行列をとると( A B ) − 1 = B − 1 A − 1 (AB)^{-1}=B^{-1}A^{-1} ( A B ) − 1 = B − 1 A − 1
( A + λ I ) − 1 = [ A ( I + λ A − 1 ) ] − 1 = ( I + λ A − 1 ) − 1 A − 1 (\boldsymbol{A} + \lambda \boldsymbol{I})^{-1}
= [\boldsymbol{A} (\boldsymbol{I} + \lambda \boldsymbol{A}^{-1})]^{-1}
= (\boldsymbol{I} + \lambda \boldsymbol{A}^{-1})^{-1} \boldsymbol{A}^{-1} ( A + λ I ) − 1 = [ A ( I + λ A − 1 ) ] − 1 = ( I + λ A − 1 ) − 1 A − 1 よって
β ^ Ridge = ( I + λ A − 1 ) − 1 A − 1 X ⊤ y = [ I + λ ( X ⊤ X ) − 1 ] − 1 ( X ⊤ X ) − 1 X ⊤ y = [ I + λ ( X ⊤ X ) − 1 ] − 1 β ^ OLS = Z β ^ OLS \begin{aligned}
\hat{\boldsymbol{\beta}}^{\text{Ridge}}
&= (\boldsymbol{I} + \lambda \boldsymbol{A}^{-1})^{-1} \boldsymbol{A}^{-1}
\boldsymbol{X}^\top \boldsymbol{y}
\\
&= [\boldsymbol{I} + \lambda (\boldsymbol{X}^\top \boldsymbol{X})^{-1}]^{-1} (\boldsymbol{X}^\top \boldsymbol{X})^{-1}
\boldsymbol{X}^\top \boldsymbol{y}
\\
&= [\boldsymbol{I} + \lambda (\boldsymbol{X}^\top \boldsymbol{X})^{-1}]^{-1} \hat{\boldsymbol{\beta}}^{\text{OLS}}
\\
&= \boldsymbol{Z} \hat{\boldsymbol{\beta}}^{\text{OLS}}
\end{aligned} β ^ Ridge = ( I + λ A − 1 ) − 1 A − 1 X ⊤ y = [ I + λ ( X ⊤ X ) − 1 ] − 1 ( X ⊤ X ) − 1 X ⊤ y = [ I + λ ( X ⊤ X ) − 1 ] − 1 β ^ OLS = Z β ^ OLS と変形することができる。ここで
Z : = [ I + λ ( X ⊤ X ) − 1 ] − 1 \boldsymbol{Z} := [\boldsymbol{I} + \lambda (\boldsymbol{X}^\top \boldsymbol{X})^{-1}]^{-1} Z := [ I + λ ( X ⊤ X ) − 1 ] − 1 とおいた。つまりRidge推定量はOLS推定量をZ Z Z
なおλ = 0 \lambda=0 λ = 0
β ^ Ridge = [ I + λ ( X ⊤ X ) − 1 ⏟ = 0 ] − 1 β ^ OLS = I − 1 β ^ OLS = β ^ OLS ( ∵ I − 1 = I ) \begin{aligned}
\hat{\boldsymbol{\beta}}^{\text{Ridge}}
&= [\boldsymbol{I} + \underbrace{ \lambda (\boldsymbol{X}^\top \boldsymbol{X})^{-1} }_{=0} ]^{-1} \hat{\boldsymbol{\beta}}^{\text{OLS}} \\
&= \boldsymbol{I}^{-1} \hat{\boldsymbol{\beta}}^{\text{OLS}} \\
&= \hat{\boldsymbol{\beta}}^{\text{OLS}} \quad (\because I^{-1} = I)\\
\end{aligned} β ^ Ridge = [ I + = 0 λ ( X ⊤ X ) − 1 ] − 1 β ^ OLS = I − 1 β ^ OLS = β ^ OLS ( ∵ I − 1 = I ) 推定量のバイアスとバリアンス ¶ 正則化しない通常の最小二乗推定量はBLUE(最良線形不偏推定量:線形不偏推定量のなかでバリアンスが最小)だった。
リッジ回帰やlassoの推定量は不偏ではない(バイアスがある)推定量であるが、最小二乗推定量よりも小さなバリアンスとなる可能性がある。
そのため、最小二乗推定法を使用する線形回帰よりもリッジ回帰のほうが予測の2乗誤差を小さくする可能性がある。
バイアス・バリアンスのトレードオフ ¶ Ridge推定量のバイアスとバリアンスは次のようになっている(鈴木 (2018)
B i a s = λ 2 ∥ ( X ⊤ X + λ I ) − 1 β ∥ 2 V a r i a n c e = σ 2 Tr [ ( X ⊤ X + λ I ) − 2 X ⊤ X ] \begin{aligned}
\mathrm{Bias} &= \lambda^2 \| ( X^\top X + \lambda I)^{-1} \boldsymbol{\beta} \|^2 \\
\mathrm{Variance} &= \sigma^2 \operatorname{Tr}\left[\left(X^{\top} X+\lambda I\right)^{-2} X^{\top} X\right]
\end{aligned} Bias Variance = λ 2 ∥ ( X ⊤ X + λ I ) − 1 β ∥ 2 = σ 2 Tr [ ( X ⊤ X + λ I ) − 2 X ⊤ X ] これらにはトレードオフの関係がある。
(1) λ → 0 \lambda \to 0 λ → 0 B i a s → 0 , V a r i a n c e → σ 2 Tr [ ( X ⊤ X ) − 1 ] \mathrm{Bias}\to 0, \mathrm{Variance} \to \sigma^2 \operatorname{Tr}[(X^{\top} X)^{-1}] Bias → 0 , Variance → σ 2 Tr [( X ⊤ X ) − 1 ]
lim λ → 0 B i a s = 0 × ∥ ( X ⊤ X ) − 1 β ∥ 2 → 0 lim λ → 0 V a r i a n c e = σ 2 Tr [ ( X ⊤ X ) − 2 X ⊤ X ] = σ 2 Tr [ ( X ⊤ X ) − 1 ] \begin{aligned}
\lim_{\lambda \to 0} \mathrm{Bias} &= 0 \times \| ( X^\top X )^{-1} \boldsymbol{\beta} \|^2 \to 0\\
\lim_{\lambda \to 0} \mathrm{Variance} &= \sigma^2 \operatorname{Tr}\left[(X^{\top} X)^{-2} X^{\top} X\right]
= \sigma^2 \operatorname{Tr}[(X^{\top} X)^{-1}]
\end{aligned} λ → 0 lim Bias λ → 0 lim Variance = 0 × ∥ ( X ⊤ X ) − 1 β ∥ 2 → 0 = σ 2 Tr [ ( X ⊤ X ) − 2 X ⊤ X ] = σ 2 Tr [( X ⊤ X ) − 1 ] (2) λ → ∞ \lambda \to \infty λ → ∞ B i a s → ∥ β ∥ 2 , V a r i a n c e → 0 \mathrm{Bias} \to \|\beta\|^2, \mathrm{Variance} \to 0 Bias → ∥ β ∥ 2 , Variance → 0
Biasについては、 ( X ⊤ X + λ I ) − 1 = λ − 1 ( I + 1 λ X ⊤ X ) − 1 \left(X^{\top} X+\lambda I\right)^{-1}=\lambda^{-1}\left(I+\frac{1}{\lambda} X^{\top} X\right)^{-1} ( X ⊤ X + λ I ) − 1 = λ − 1 ( I + λ 1 X ⊤ X ) − 1 ∥ c x ∥ 2 = c 2 ∥ x ∥ 2 \| c \boldsymbol{x} \|^2 = c^2 \| \boldsymbol{x} \|^2 ∥ c x ∥ 2 = c 2 ∥ x ∥ 2
λ 2 ∥ ( X ⊤ X + λ I ) − 1 β ∥ 2 = λ 2 ∥ λ − 1 ( I + 1 λ X ⊤ X ) − 1 β ∥ 2 = ∥ ( I + 1 λ X ⊤ X ) − 1 β ∥ 2 \begin{aligned}
\lambda^2\left\|\left(X^{\top} X+\lambda I\right)^{-1} \beta\right\|^2
=\lambda^2\left\|\lambda^{-1}\left(I+\frac{1}{\lambda} X^{\top} X\right)^{-1} \beta\right\|^2
=\left\|\left(I+\frac{1}{\lambda} X^{\top} X\right)^{-1} \beta\right\|^2
\end{aligned} λ 2 ∥ ∥ ( X ⊤ X + λ I ) − 1 β ∥ ∥ 2 = λ 2 ∥ ∥ λ − 1 ( I + λ 1 X ⊤ X ) − 1 β ∥ ∥ 2 = ∥ ∥ ( I + λ 1 X ⊤ X ) − 1 β ∥ ∥ 2 となる。
ここでλ → ∞ \lambda \to \infty λ → ∞ ∥ ( I + 1 λ X ⊤ X ) − 1 β ∥ 2 \left\|\left(I+\frac{1}{\lambda} X^{\top} X\right)^{-1} \beta\right\|^2 ∥ ∥ ( I + λ 1 X ⊤ X ) − 1 β ∥ ∥ 2 1 λ X ⊤ X → 0 \frac{1}{\lambda} X^{\top} X \to 0 λ 1 X ⊤ X → 0 I − 1 = I I^{-1} = I I − 1 = I
lim λ → ∞ B i a s = ∥ ( I + 1 λ X ⊤ X ) − 1 β ∥ 2 = ∥ I − 1 β ∥ 2 ( ∵ 1 λ X ⊤ X → 0 ) = ∥ β ∥ 2 ( ∵ I − 1 = I ) \begin{aligned}
\lim_{\lambda \to \infty} \mathrm{Bias}
&= \left\|\left(I + \frac{1}{\lambda} X^{\top} X \right)^{-1} \beta\right\|^2 \\
&= \left\|I^{-1} \beta\right\|^2 \quad (\because \frac{1}{\lambda} X^{\top} X \to 0 ) \\
&= \left\| \beta \right\|^2 \quad (\because I^{-1} = I)
\end{aligned} λ → ∞ lim Bias = ∥ ∥ ( I + λ 1 X ⊤ X ) − 1 β ∥ ∥ 2 = ∥ ∥ I − 1 β ∥ ∥ 2 ( ∵ λ 1 X ⊤ X → 0 ) = ∥ β ∥ 2 ( ∵ I − 1 = I ) Variance σ 2 Tr [ ( X ⊤ X + λ I ) − 2 X ⊤ X ] \sigma^2 \operatorname{Tr}\left[\left(X^{\top} X+\lambda I\right)^{-2} X^{\top} X\right] σ 2 Tr [ ( X ⊤ X + λ I ) − 2 X ⊤ X ]
( X ⊤ X + λ I ) − 2 = λ − 2 ( I + 1 λ X ⊤ X ) − 2 (X^{\top} X +\lambda I)^{-2}
=\lambda^{-2}\left(I+\frac{1}{\lambda} X^{\top} X \right)^{-2} ( X ⊤ X + λ I ) − 2 = λ − 2 ( I + λ 1 X ⊤ X ) − 2 であり、 ( I + 1 λ X ⊤ X ) − 2 \left(I+\frac{1}{\lambda} X^{\top} X \right)^{-2} ( I + λ 1 X ⊤ X ) − 2 λ → ∞ \lambda \to \infty λ → ∞ I I I
lim λ → ∞ V a r i a n c e = σ 2 Tr [ λ − 2 X ⊤ X ] = λ − 2 ⋅ σ 2 Tr [ X ⊤ X ] = 1 λ 2 ⋅ σ 2 Tr [ X ⊤ X ] = 0 \begin{aligned}
\lim_{\lambda \to \infty} \mathrm{Variance}
&= \sigma^2 \operatorname{Tr}\left[\lambda ^{-2} X^{\top} X\right]\\
&= \lambda^{-2} \cdot \sigma^2 \operatorname{Tr}\left[X^{\top} X\right]\\
&= \frac{1}{\lambda^{2}} \cdot \sigma^2 \operatorname{Tr}\left[X^{\top} X\right]\\
&= 0
\end{aligned} λ → ∞ lim Variance = σ 2 Tr [ λ − 2 X ⊤ X ] = λ − 2 ⋅ σ 2 Tr [ X ⊤ X ] = λ 2 1 ⋅ σ 2 Tr [ X ⊤ X ] = 0 バリアンス ¶ Var ( β ^ Ridge ) = σ 2 ( X ⊤ X + λ I ) − 1 X ⊤ X ( X ⊤ X + λ I ) − 1 ≤ σ 2 ( X ⊤ X ) − 1 = Var ( β ^ LS ) \begin{aligned}
\operatorname{Var}(\hat{\beta}^{\text{Ridge}})
&= \sigma^2 (X^\top X + \lambda I)^{-1} X^\top X(X^\top X + \lambda I)^{-1}\\
&\leq \sigma^2 (X^\top X)^{-1} = \operatorname{Var}(\hat{\beta}^{\text{LS}})
\end{aligned} Var ( β ^ Ridge ) = σ 2 ( X ⊤ X + λ I ) − 1 X ⊤ X ( X ⊤ X + λ I ) − 1 ≤ σ 2 ( X ⊤ X ) − 1 = Var ( β ^ LS ) https://
線形回帰モデルy = X β + u y = X\beta + u y = Xβ + u β ^ O L S = ( X ⊤ X ) − 1 X ⊤ y \hat{\beta}^{OLS} = (X^\top X)^{-1} X^\top y β ^ O L S = ( X ⊤ X ) − 1 X ⊤ y
β ^ O L S = ( X ⊤ X ) − 1 X ⊤ y = ( X ⊤ X ) − 1 X ⊤ ( X β + u ) = ( X ⊤ X ) − 1 X ⊤ X β + ( X ⊤ X ) − 1 X ⊤ u = β + ( X ⊤ X ) − 1 X ⊤ u \begin{align}
\hat{\beta}^{OLS}
&= (X^\top X)^{-1} X^\top y\\
&= (X^\top X)^{-1} X^\top (X\beta + u)\\
&= (X^\top X)^{-1} X^\top X\beta + (X^\top X)^{-1} X^\top u\\
&= \beta + (X^\top X)^{-1} X^\top u\\
\end{align} β ^ O L S = ( X ⊤ X ) − 1 X ⊤ y = ( X ⊤ X ) − 1 X ⊤ ( Xβ + u ) = ( X ⊤ X ) − 1 X ⊤ Xβ + ( X ⊤ X ) − 1 X ⊤ u = β + ( X ⊤ X ) − 1 X ⊤ u β ^ O L S = β + ( X ⊤ X ) − 1 X ⊤ u \hat{\beta}^{OLS} = \beta + (X^\top X)^{-1} X^\top u β ^ O L S = β + ( X ⊤ X ) − 1 X ⊤ u u ∼ N ( 0 , σ 2 I ) u\sim N(0, \sigma^2 I) u ∼ N ( 0 , σ 2 I ) β ^ O L S ∼ N ( β , σ 2 ( X ⊤ X ) − 1 ) \hat{\beta}^{OLS} \sim N(\beta, \sigma^2 (X^\top X)^{-1}) β ^ O L S ∼ N ( β , σ 2 ( X ⊤ X ) − 1 )
定理
u u u μ ∈ R n \mu\in\mathbb{R}^n μ ∈ R n b ∈ R p b\in\mathbb{R}^p b ∈ R p C ∈ R p × n C\in\mathbb{R}^{p\times n} C ∈ R p × n rank C = p \operatorname{rank} C = p rank C = p
u ∼ N ( μ , Σ ) u \sim N(\mu, \Sigma) u ∼ N ( μ , Σ ) C u + b ∼ N ( C μ + b , C Σ C ⊤ ) Cu + b \sim N(C\mu + b, C\Sigma C^\top) C u + b ∼ N ( C μ + b , C Σ C ⊤ )
したがって Var [ β ^ O L S ] = σ 2 ( X ⊤ X ) − 1 \operatorname{Var}[\hat{\beta}^{OLS}] = \sigma^2 (X^\top X)^{-1} Var [ β ^ O L S ] = σ 2 ( X ⊤ X ) − 1
C : = ( X ⊤ X ) − 1 X ⊤ C := (X^\top X)^{-1} X^\top C := ( X ⊤ X ) − 1 X ⊤
C ⊤ = [ ( X ⊤ X ) − 1 X ⊤ ] ⊤ = X [ ( X ⊤ X ) − 1 ] ⊤ ( ∵ ( A B ) ⊤ = B ⊤ A ⊤ ) = X [ ( X ⊤ X ) ⊤ ] − 1 ( ∵ ( A − 1 ) ⊤ = ( A ⊤ ) − 1 ) = X ( X ⊤ X ) − 1 ( ∵ ( X ⊤ X ) ⊤ = X ⊤ X ) \begin{aligned}
C^\top = [(X^\top X)^{-1} X^\top]^\top
&= X [(X^\top X)^{-1}]^\top \quad (\because (AB)^\top = B^\top A^\top) \\
&= X [(X^\top X)^\top]^{-1} \quad (\because (A^{-1})^\top = (A^\top)^{-1} ) \\
&= X (X^\top X)^{-1} \quad (\because (X^\top X)^\top=X^\top X ) \\
\end{aligned} C ⊤ = [( X ⊤ X ) − 1 X ⊤ ] ⊤ = X [( X ⊤ X ) − 1 ] ⊤ ( ∵ ( A B ) ⊤ = B ⊤ A ⊤ ) = X [( X ⊤ X ) ⊤ ] − 1 ( ∵ ( A − 1 ) ⊤ = ( A ⊤ ) − 1 ) = X ( X ⊤ X ) − 1 ( ∵ ( X ⊤ X ) ⊤ = X ⊤ X ) であるため、u ∼ N ( 0 , σ 2 I ) u\sim N(0, \sigma^2 I) u ∼ N ( 0 , σ 2 I )
β + C u ∼ N ( β , σ 2 C C ⊤ ) = β + ( X ⊤ X ) − 1 X ⊤ u ∼ N ( β , σ 2 ( X ⊤ X ) − 1 X ⊤ X ( X ⊤ X ) − 1 ) = β + ( X ⊤ X ) − 1 X ⊤ u ∼ N ( β , σ 2 ( X ⊤ X ) − 1 ) \begin{aligned}
&\beta + C u \sim N(\beta, \sigma^2 CC^\top)\\
&= \beta + (X^\top X)^{-1} X^\top u \sim
N(\beta, \sigma^2 (X^\top X)^{-1} X^\top X (X^\top X)^{-1} )\\
&= \beta + (X^\top X)^{-1} X^\top u \sim
N(\beta, \sigma^2 (X^\top X)^{-1})
\end{aligned} β + C u ∼ N ( β , σ 2 C C ⊤ ) = β + ( X ⊤ X ) − 1 X ⊤ u ∼ N ( β , σ 2 ( X ⊤ X ) − 1 X ⊤ X ( X ⊤ X ) − 1 ) = β + ( X ⊤ X ) − 1 X ⊤ u ∼ N ( β , σ 2 ( X ⊤ X ) − 1 ) (導出部分は書籍を参考にしたのではなくChatGPTと会話しながら考えたので誤ってる可能性あり)
線形回帰モデルy = X β + u \boldsymbol{y} = \boldsymbol{X} \boldsymbol{\beta} + \boldsymbol{u} y = X β + u
β ^ Ridge = ( X ⊤ X + λ I ) − 1 X ⊤ y = ( X ⊤ X + λ I ) − 1 X ⊤ ( X β + u ) = ( X ⊤ X + λ I ) − 1 X ⊤ X β + ( X ⊤ X + λ I ) − 1 X ⊤ u \begin{aligned}
\hat{\boldsymbol{\beta}}^{\text{Ridge}}
&= (\boldsymbol{X}^\top \boldsymbol{X} + \lambda \boldsymbol{I})^{-1} \boldsymbol{X}^\top \boldsymbol{y}\\
&= (\boldsymbol{X}^\top \boldsymbol{X} + \lambda \boldsymbol{I})^{-1} \boldsymbol{X}^\top (\boldsymbol{X} \boldsymbol{\beta} + \boldsymbol{u})\\
&= (\boldsymbol{X}^\top \boldsymbol{X} + \lambda \boldsymbol{I})^{-1} \boldsymbol{X}^\top \boldsymbol{X} \boldsymbol{\beta}
+ (\boldsymbol{X}^\top \boldsymbol{X} + \lambda \boldsymbol{I})^{-1} \boldsymbol{X}^\top \boldsymbol{u}\\
\end{aligned} β ^ Ridge = ( X ⊤ X + λ I ) − 1 X ⊤ y = ( X ⊤ X + λ I ) − 1 X ⊤ ( X β + u ) = ( X ⊤ X + λ I ) − 1 X ⊤ X β + ( X ⊤ X + λ I ) − 1 X ⊤ u 第1項は標本分布によるばらつきがないバイアス項なので第2項だけが関わる。つまり、
Var [ β ^ Ridge ] = Var [ ( X ⊤ X + λ I ) − 1 X ⊤ u ] \operatorname{Var}[\hat{\boldsymbol{\beta}}^{\text{Ridge}}]
= \operatorname{Var}[ (\boldsymbol{X}^\top \boldsymbol{X} + \lambda \boldsymbol{I})^{-1} \boldsymbol{X}^\top \boldsymbol{u} ] Var [ β ^ Ridge ] = Var [( X ⊤ X + λ I ) − 1 X ⊤ u ] である。
分散には行列A A A u u u Var [ A u ] = A Var [ u ] A ⊤ \operatorname{Var}[Au]= A\operatorname{Var}[u]A^\top Var [ A u ] = A Var [ u ] A ⊤ A : = ( X ⊤ X + λ I ) − 1 X ⊤ \boldsymbol{A} :=(\boldsymbol{X}^\top \boldsymbol{X} + \lambda \boldsymbol{I})^{-1} \boldsymbol{X}^\top A := ( X ⊤ X + λ I ) − 1 X ⊤
Var [ β ^ Ridge ] = Var [ ( X ⊤ X + λ I ) − 1 X ⊤ u ] = Var [ A u ] = A Var [ u ] A ⊤ = ( X ⊤ X + λ I ) − 1 X ⊤ Var [ u ] [ ( X ⊤ X + λ I ) − 1 X ⊤ ] ⊤ = ( X ⊤ X + λ I ) − 1 X ⊤ Var [ u ] X ( X ⊤ X + λ I ) − 1 \begin{aligned}
\operatorname{Var}[\hat{\boldsymbol{\beta}}^{\text{Ridge}}]
&= \operatorname{Var}[ (\boldsymbol{X}^\top \boldsymbol{X} + \lambda \boldsymbol{I})^{-1} \boldsymbol{X}^\top \boldsymbol{u} ]\\
&= \operatorname{Var}[ \boldsymbol{A} \boldsymbol{u} ]\\
&= \boldsymbol{A} \operatorname{Var}[\boldsymbol{u}] \boldsymbol{A}^\top \\
&= (\boldsymbol{X}^\top \boldsymbol{X} + \lambda \boldsymbol{I})^{-1} \boldsymbol{X}^\top \operatorname{Var}[\boldsymbol{u}] [(\boldsymbol{X}^\top \boldsymbol{X} + \lambda \boldsymbol{I})^{-1} \boldsymbol{X}^\top]^\top \\
&= (\boldsymbol{X}^\top \boldsymbol{X} + \lambda \boldsymbol{I})^{-1} \boldsymbol{X}^\top \operatorname{Var}[\boldsymbol{u}] \boldsymbol{X} (\boldsymbol{X}^\top \boldsymbol{X} + \lambda \boldsymbol{I})^{-1} \\
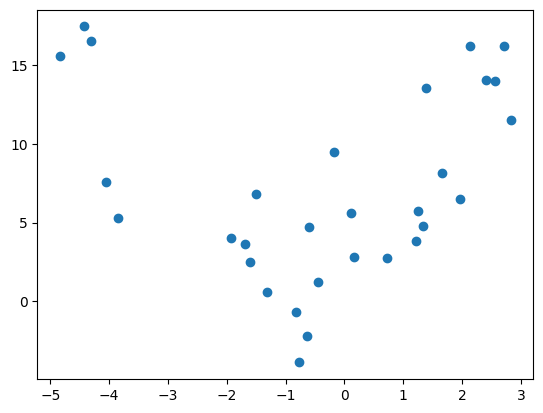
\end{aligned} Var [ β ^ Ridge ] = Var [( X ⊤ X + λ I ) − 1 X ⊤ u ] = Var [ A u ] = A Var [ u ] A ⊤ = ( X ⊤ X + λ I ) − 1 X ⊤ Var [ u ] [( X ⊤ X + λ I ) − 1 X ⊤ ] ⊤ = ( X ⊤ X + λ I ) − 1 X ⊤ Var [ u ] X ( X ⊤ X + λ I ) − 1 モンテカルロ・シミュレーション ¶ 多項式をつかったデータに、多項式回帰をfittingしてみる
y = β 0 + β 1 x + β 2 x 2 + u y = \beta_0 + \beta_1 x + \beta_2 x^2 + u y = β 0 + β 1 x + β 2 x 2 + u import numpy as np
beta = np.array([3, 2, 1])
def gen_data(seed=0, n=500):
np.random.seed(seed)
x = np.random.uniform(-5, 3, size=n)
X = np.array([np.ones(n), x, x**2]).T
u = np.random.normal(scale=3, size=n)
y = X @ beta + u
return X, y
import matplotlib.pyplot as plt
X, y = gen_data(seed=0, n=30)
plt.scatter(X[:, 1], y)class OLS:
def fit(self, X, y):
self.beta_ = np.linalg.inv(X.T @ X) @ X.T @ y
return self
def predict(self, X):
return X @ self.beta_
class Ridge:
def __init__(self, lamb = 0.1):
self.lambda_ = lamb
def fit(self, X, y):
d = X.shape[1]
I = np.ones((d, d))
self.beta_ = np.linalg.inv((X.T @ X) + self.lambda_ * I) @ X.T @ y
return self
def predict(self, X):
return X @ self.beta_
from sklearn.metrics import mean_squared_error
results = []
for i in range(500):
result = {}
X_train, y_train = gen_data(seed=i, n=30)
X_test, y_test = gen_data(seed=i+1, n=100)
reg = OLS().fit(X_train, y_train)
y_pred = reg.predict(X_test)
result["ols_beta"] = reg.beta_[1]
result["ols_error"] = mean_squared_error(y_test, y_pred)
reg = Ridge(lamb=1).fit(X_train, y_train)
y_pred = reg.predict(X_test)
result["ridge_beta"] = reg.beta_[1]
result["ridge_error"] = mean_squared_error(y_test, y_pred)
results.append(result)
import pandas as pd
results = pd.DataFrame(results)
print(f"""
beta1
bias:
- ols: {beta[1] - results["ols_beta"].mean():.3f}
- ridge: {beta[1] - results["ridge_beta"].mean():.3f}
variance:
- ols: {results["ols_beta"].var():.3f}
- ridge: {results["ridge_beta"].var():.3f}
""")
beta1

bias:
- ols: -0.026
- ridge: 0.038

variance:
- ols: 0.115
- ridge: 0.110
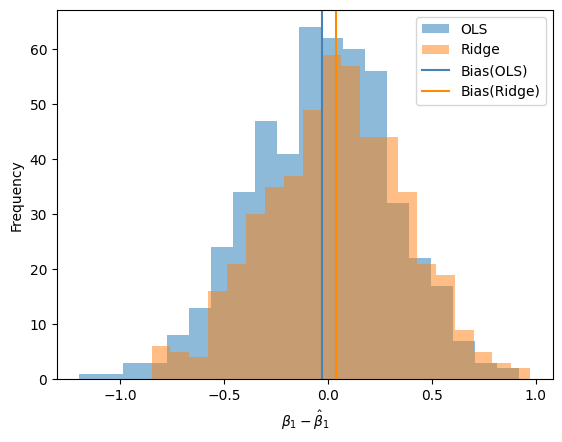
ridgeのほうがvarianceが若干小さくbiasが大きくなっている
fig, ax = plt.subplots()
ax.hist(beta[1] - results["ols_beta"], label="OLS", alpha=0.5, bins=20)
ax.hist(beta[1] - results["ridge_beta"], label="Ridge", alpha=0.5, bins=20)
ax.axvline(beta[1] - results["ols_beta"].mean(), label="Bias(OLS)", color="steelblue")
ax.axvline(beta[1] - results["ridge_beta"].mean(), label="Bias(Ridge)", color="darkorange")
ax.legend()
ax.set(xlabel=r"$\beta_1 - \hat\beta_1$", ylabel="Frequency")
fig.show()
fig, ax = plt.subplots()
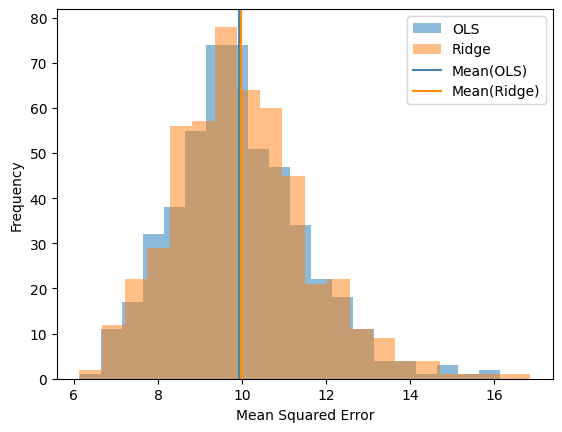
ax.hist(results["ols_error"], label="OLS", alpha=0.5, bins=20)
ax.hist(results["ridge_error"], label="Ridge", alpha=0.5, bins=20)
ax.axvline(results["ols_error"].mean(), label="Mean(OLS)", color="steelblue")
ax.axvline(results["ridge_error"].mean(), label="Mean(Ridge)", color="darkorange")
ax.legend()
ax.set(xlabel="Mean Squared Error", ylabel="Frequency")
fig.show()