マルコフの不等式
指示関数I(⋅)をもちいて
E[X]=E[X{I(X≥c)+I(X<c)}]≥E[XI(X≥c)]≥cE[I(X≥c)]=cP(X≥c) マルコフの不等式は 期待値よりも極端に大きな値を取る確率が低い ことを意味する。
例えばc=5E[X]とおけば
P(X≥5E[X])≤5E[X]E[X]=51 from scipy.stats import expon
mean = 2 # 期待値 E[X] = 2 の指数分布は scale=2
dist = expon(scale=mean)
threshold = 5 * mean # 5 * E[X]
# P(X >= 5 * E[X]) = 1 - CDF(threshold)
prob = 1 - dist.cdf(threshold)
upper_bound = 1 / 5 # マルコフの不等式の上限
print(f"P(X >= 5E[X]) = {prob:.2g}")
print(f"Markov Inequality Upper Bound = {upper_bound:.2g}")
P(X >= 5E[X]) = 0.0067
Markov Inequality Upper Bound = 0.2
チェビシェフの不等式
Y=(X−μ)2とおき、Yにマルコフの不等式
P(X≥c)≤cE[X] を適用すれば、
P(Y≥c2)≤c2E[Y]=c2σ2 ここで Y≥c2⟺∣X−μ∣≥c であるから P(Y≥c2)=P(∣X−μ∣≥c) となり
P(∣X−μ∣≥c)≤c2σ2 が成立する
チェビシェフの不等式は 期待値から値が極端に離れる確率が低い ことを意味する。
例えばc=5σとおけば
P(∣X−μ∣≥5σ)≤5σ2σ2=51 例:2シグマ範囲
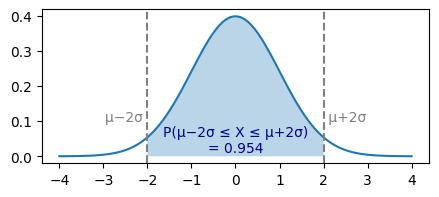
期待値からの2シグマ範囲には正規分布だと95%が入る。
import numpy as np
from scipy.stats import norm
mu = 0       # 平均
sigma = 1    # 標準偏差
lower = mu - 2 * sigma
upper = mu + 2 * sigma
dist = norm(loc=mu, scale=sigma)
# P(∣X−μ∣ ≤ 2σ) = P(μ−2σ ≤ X ≤ μ+2σ) = cdf(μ+2σ) - cdf(μ-2σ)
p_2sigma = dist.cdf(upper) - dist.cdf(lower) # P(-2σ <= X <= 2σ)
print(f"P(∣X−μ∣ ≤ 2σ) = {p_2sigma:.3f}")
import matplotlib.pyplot as plt

# plot
fig, ax = plt.subplots(figsize=[5, 2])
x = np.linspace(-4, 4, 100)
y = dist.pdf(x)
ax.plot(x, y)

# 2σ points
x_2sig = dist.ppf(dist.cdf(2 * sigma))
ax.axvline(mu + x_2sig, color="gray", linestyle="--")
ax.axvline(mu - x_2sig, color="gray", linestyle="--")
ax.text(mu + x_2sig, 0.1, f" μ+2σ", ha="left", color="gray")
ax.text(mu - x_2sig, 0.1, f"μ−2σ ", ha="right", color="gray")

x = np.linspace(mu - x_2sig, mu + x_2sig, 100)
y = dist.pdf(x)
ax.fill_between(x, y, 0, alpha=0.3)

ax.text(0, 0.01, f"P(μ−2σ ≤ X ≤ μ+2σ)\n= {p_2sigma:.3f}", ha="center", color="darkblue")
plt.show()
チェビシェフの不等式による任意の分布への下限は
P(X∈[μ−2σ,μ+2σ])=P(∣X−μ∣≤2σ)≥1−P(∣X−μ∣≥2σ)=1−4σ2σ2=1−41=43 となり、正規分布以外でも75%以上あることがわかる
例:期待値からのズレ
n個のサンプルX1,…,Xnがi.i.d.であるとする。これらのサンプルの標本平均Xˉがその期待値E[Xˉ]からどれだけズレるかを見てみる
P(∣Xˉ−E[Xˉ]∣≥c)≤c2Var[Xˉ] もしc=1なら、標本平均と期待値の差の絶対値が1以上になる確率はその分散が上限になるということ。
P(∣Xˉ−E[Xˉ]∣≥1)≤Var[Xˉ]=nVar[X] 例えばサンプルが商談から成約したかどうかであり、真の成約率が20%という確率変数X∼Ber(p=0.2) の実現値だとすると、E[Xˉ]=0.2,Var[Xˉ]=p(1−p)=0.16で、このときc=0.1とおけば
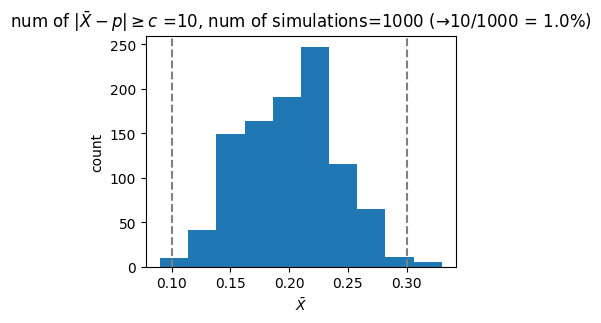
P(∣Xˉ−0.2∣≥0.1)≤n×0.120.16=n16 となり、仮にn=100なら16%程度の確率が上限(分布によらない上限)になることがわかる
import numpy as np
from scipy.stats import bernoulli
import matplotlib.pyplot as plt
p = 0.2
dist = bernoulli(p=p)
n = 100
c = 0.1
bound = p * (1-p) / n / c**2

n_trials = 1000
x_bars = []
for i in range(n_trials):
    x = dist.rvs(size=n, random_state=i)
    x_bars.append( x.mean() )

fig, ax = plt.subplots(figsize=[4, 3])
ax.hist(x_bars, bins=10)
ax.axvline(p + c, color="gray", linestyle="--")
ax.axvline(p - c, color="gray", linestyle="--")

x_bars = np.array(x_bars)
is_over = np.abs(x_bars - p) >= c

ax.set(
    # title=r"histogram of $\bar{X}$",
    title=r"num of |$\bar{X} - p| \geq c$ =" + f"{is_over.sum()}, num of simulations={n_trials} (→{is_over.sum()}/{n_trials} = {is_over.sum() / n_trials:.1%})",
    xlabel=r"$\bar{X}$",
    ylabel="count"
)
fig.show()
ヘフディングの不等式
チェビシェフの不等式は幅広い範囲で有用ではあるものの、裾の確率を緩く評価してしまう。
例えば上記の期待値からのズレの例
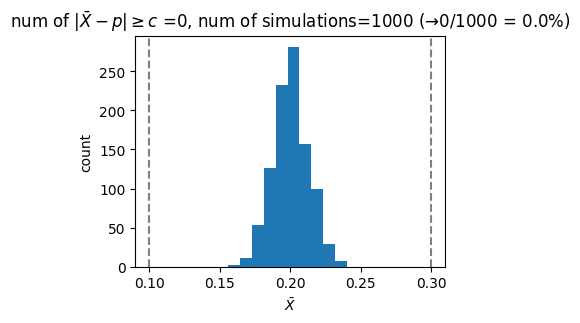
P(∣Xˉ−0.2∣≥0.1)≤n16 では、n=1000であっても「1.6%は起こるかもしれない」というかなり安全に寄った評価をしてしまう。これは実際にシミュレーションすると0%になるレベルの稀少な事例にもかかわらず。
import numpy as np
from scipy.stats import bernoulli
import matplotlib.pyplot as plt
p = 0.2
dist = bernoulli(p=p)
n = 1000
c = 0.1
bound = p * (1-p) / n / c**2

n_trials = 1000
x_bars = []
for i in range(n_trials):
    x = dist.rvs(size=n, random_state=i)
    x_bars.append( x.mean() )

fig, ax = plt.subplots(figsize=[4, 3])
ax.hist(x_bars, bins=10)
ax.axvline(p + c, color="gray", linestyle="--")
ax.axvline(p - c, color="gray", linestyle="--")

x_bars = np.array(x_bars)
is_over = np.abs(x_bars - p) >= c

ax.set(
    # title=r"histogram of $\bar{X}$",
    title=r"num of |$\bar{X} - p| \geq c$ =" + f"{is_over.sum()}, num of simulations={n_trials} (→{is_over.sum()}/{n_trials} = {is_over.sum() / n_trials:.1%})",
    xlabel=r"$\bar{X}$",
    ylabel="count"
)
fig.show()
このような裾の確率をより厳しく抑えるのに役立つのが ヘフディングの不等式 (Hoeffding’s inequality)
すべての確率変数Xiが区間[0,1]に値を取る場合はもっと単純に
P(∣Xˉ−E[Xˉ]∣≥c)≤2exp(−2nc2) となる。
前出の成約率の例だと、n=1000,c=0.1のとき
P(∣Xˉ−E[Xˉ]∣≥0.1)≤2exp(−2×1000×0.12)=2exp(−20)≈4.122×10⁻⁹≈0 となり、観測結果に近くなる。
しかしn=100,c=0.1のとき
P(∣Xˉ−E[Xˉ]∣≥0.1)≤2exp(−2×100×0.12)=2exp(−2)≈0.27 とだいぶ大きく評価することもある様子…?
平均2乗収束
チェビシェフの不等式を使うと「確率変数列がある確率変数に平均2乗収束するならば確率収束する」という命題が導かれる → 大数の法則
例:大数の法則
ε>0を任意の定数とする。E[Xˉn]=μ,Var[Xˉn]=σ2/nであるから、Xˉにチェビシェフの不等式を適用すれば
P(∣Xˉn−μ∣≥ε)≤nε2σ2 となる。ここでn→∞とおけば右辺は0に収束するから
∀ε>0,n→∞limP(∣Xˉn−μ∣≥ε)=0 例:推定量の一致性
推定量θ^が真のパラメータθに確率収束
θ^→pθ するとき、その推定量は一致性(consistency)を持つという
例:中心極限定理
確率変数列{Xn}n=1∞はi.i.d.で平均μ:=E[Xi]と分散σ2:=Var(Xi)が存在するとする。このとき、以下の分布収束が成り立つ
n(Xˉ−μ)→dN(0,σ2),n→∞ ここでN(0,σ2)をXˉの漸近分布(asymptoticd distribution)という。
(※なお、N(0,σ2)は正規分布を表す記号ではなく、正規分布に従う確率変数を意味するので注意。ややこしい記法だが標準的でよく見られる書き方である)
なお、上の式は
Xˉ−μ→dn1N(0,σ2)=N(0,nσ2) のように整理できる。
(σ2は未知だが標本分散を用いてもこの関係性が成り立つ)