統計的仮説検定 ¶ 帰無仮説 (null hypothesis)H 0 H_0 H 0 対立仮説 (alternative hypothesis)H 1 H_1 H 1
例えば、母集団の確率分布をf ( x ∣ θ ) f(x|\theta) f ( x ∣ θ )
H 0 : θ = θ 0 vs H 1 : θ ≠ θ 0 H_0: \theta = \theta_0
\text{ vs }
H_1: \theta \neq \theta_0 H 0 : θ = θ 0 vs H 1 : θ = θ 0 のように帰無仮説と対立仮説を設定する。
なお、対立仮説がθ ≠ θ 0 \theta \neq \theta_0 θ = θ 0 θ > θ 0 \theta > \theta_0 θ > θ 0 θ < θ 0 \theta < \theta_0 θ < θ 0 両側検定 (two-sided test)という。
またθ > θ 0 \theta > \theta_0 θ > θ 0 片側検定 (one-sided test)という。
仮説検定方式 ¶ 標本空間X \mathcal{X} X H 0 H_0 H 0
とに分割するルールのことを仮説検定方式 (hypothesis testing procedure)という。
また標本X 1 , … , X n X_1,\dots,X_n X 1 , … , X n T = T ( X 1 , … , X n ) T=T(X_1,\dots,X_n) T = T ( X 1 , … , X n ) R R R A A A T T T 検定統計量 (test statistic)という。
有意水準 ¶ もし帰無仮説を棄却したとき、その判断が間違っている可能性をコントロールしたい。
そこで、帰無仮説H 0 H_0 H 0 H 0 H_0 H 0 θ ∈ Θ 0 \theta \in \Theta_0 θ ∈ Θ 0 α \alpha α
sup θ ∈ Θ 0 P θ ( X ∈ R ) ≤ α \sup_{\theta \in \Theta_0} P_{\theta} (\boldsymbol{X} \in R) \leq \alpha θ ∈ Θ 0 sup P θ ( X ∈ R ) ≤ α を満たすように棄却域を調整する。このα \alpha α 有意水準 (significance leve)という。
ここでΘ 0 \Theta_0 Θ 0 θ \theta θ 母数空間 (parameter space)Θ \Theta Θ Θ 0 = { θ ∣ θ = θ 0 } \Theta_0 = \{ \theta | \theta = \theta_0 \} Θ 0 = { θ ∣ θ = θ 0 }
(例)
例えば、標本平均がある値μ 0 \mu_0 μ 0
H 0 : μ = μ 0 vs H 1 : μ ≠ μ 0 H_0: \mu = \mu_0 \text{ vs } H_1: \mu \neq \mu_0 H 0 : μ = μ 0 vs H 1 : μ = μ 0 という両側検定は、適当な定数C C C
と書き換えることができる。この場合、∣ X ˉ − μ 0 ∣ |\bar{X} - \mu_0| ∣ X ˉ − μ 0 ∣ H 0 H_0 H 0
R = { x ∈ X ∣ ∣ X ˉ − μ 0 ∣ > C } R = \big\{ x \in \mathcal{X} \ \big|\ |\bar{X} - \mu_0| > C \big\} R = { x ∈ X ∣ ∣ ∣ X ˉ − μ 0 ∣ > C } となる。
有意水準がα \alpha α C C C
P μ = μ 0 ( ∣ X ˉ − μ 0 ∣ > C ) = α P_{\mu = \mu_0}( |\bar{X} - \mu_0| > C) = \alpha P μ = μ 0 ( ∣ X ˉ − μ 0 ∣ > C ) = α となるようなC C C
Z = n ( X ˉ − μ 0 ) / σ Z = \sqrt{n} (\bar{X} - \mu_0) / \sigma Z = n ( X ˉ − μ 0 ) / σ μ = μ 0 \mu = \mu_0 μ = μ 0 Z ∼ N ( 0 , 1 ) Z \sim N(0, 1) Z ∼ N ( 0 , 1 )
TODO: 続きかく
import numpy as np
from scipy import stats
import pandas as pd
import matplotlib.pyplot as plt
正規母集団に関する検定 ¶ 母集団の分布が正規分布ときの検定について。
母平均に関する検定 ¶ 母平均μ \mu μ σ 2 \sigma^2 σ 2
両側検定H 0 : μ = μ 0 vs H 1 : μ ≠ μ 0 H_0: \mu = \mu_0 \text{ vs } H_1: \mu \neq \mu_0 H 0 : μ = μ 0 vs H 1 : μ = μ 0
σ 2 \sigma^2 σ 2 ¶ 検定統計量は標本平均X ˉ \bar{X} X ˉ
Z = X ˉ − μ σ / n Z = \frac{\bar{X} - \mu}{\sigma / \sqrt{n}} Z = σ / n X ˉ − μ を使用する。
帰無仮説が正しければ、標本平均は中心極限定理により正規分布N ( μ , σ 2 / n ) N(\mu, \sigma^2 / n) N ( μ , σ 2 / n ) Z Z Z N ( 0 , 1 ) N(0, 1) N ( 0 , 1 ) R R R Z α / 2 Z_{\alpha/2} Z α /2
R = { x ∈ X ∣ ∣ Z ∣ > Z α / 2 } R = \big\{ x \in \mathcal{X} \ \big|\ |Z| > Z_{\alpha/2} \big\} R = { x ∈ X ∣ ∣ ∣ Z ∣ > Z α /2 } 言い換えると
∣ Z ∣ > Z α / 2 ⟹ H 0 を棄却 ∣ Z ∣ ≤ Z α / 2 ⟹ H 0 を受容 |Z| > Z_{\alpha/2} \implies H_0\text{を棄却}\\
|Z| \leq Z_{\alpha/2} \implies H_0\text{を受容}\\ ∣ Z ∣ > Z α /2 ⟹ H 0 を棄却 ∣ Z ∣ ≤ Z α /2 ⟹ H 0 を受容 とする。(絶対値を使うのは正規分布が原点に対し対称な分布であるため)
σ 2 \sigma^2 σ 2 ¶ 母分散σ 2 \sigma^2 σ 2 s 2 s^2 s 2 t t t
t = X ˉ − μ s / n t = \frac{ \bar{X} - \mu }{ s /\sqrt{n} } t = s / n X ˉ − μ を使用する。
帰無仮説が正しければ、検定統計量t t t n − 1 n-1 n − 1 t t t t α / 2 ( n − 1 ) t_{\alpha/2}(n-1) t α /2 ( n − 1 )
∣ t ∣ > t α / 2 ( n − 1 ) ⟹ reject ∣ t ∣ ≤ t α / 2 ( n − 1 ) ⟹ accept |t| > t_{\alpha/2}(n-1) \implies \text{reject}\\
|t| \leq t_{\alpha/2}(n-1) \implies \text{accept}\\ ∣ t ∣ > t α /2 ( n − 1 ) ⟹ reject ∣ t ∣ ≤ t α /2 ( n − 1 ) ⟹ accept とする。
カイ2乗適合度検定 ¶ クロス表(多項分布)において、観測データの確率分布が理論上想定される確率分布に等しいかどうかを調べる検定がカイ2乗適合度検定である。
n n n K K K X 1 , … , X K X_1, \dots, X_K X 1 , … , X K X 1 + ⋯ + X K = n X_1 + \cdots + X_K = n X 1 + ⋯ + X K = n
それぞれのカテゴリーに入る(真の)確率をp 1 , … , p K p_1, \dots, p_K p 1 , … , p K p 1 + ⋯ + p K = 1 p_1 + \cdots + p_K=1 p 1 + ⋯ + p K = 1
p i p_i p i X i / n X_i/n X i / n π 1 , … , π K \pi_1, \dots, \pi_K π 1 , … , π K
H 0 : p 1 = π 1 , … , p K = π K H 1 : p i ≠ π i ( ある i に対して ) \begin{align}
H_0&: p_1 = \pi_1, \dots, p_K = \pi_K\\
H_1&: p_i \neq \pi_i \ (\text{ある}i\text{に対して})
\end{align} H 0 H 1 : p 1 = π 1 , … , p K = π K : p i = π i ( ある i に対して ) これをカテゴリーに関するカイ2乗適合度検定 (chi-square test of goodness of fit)という。
H 0 H_0 H 0 C i C_i C i n × π i n \times \pi_i n × π i
( X 1 − n π 1 ) 2 , … , ( X K − n π K ) 2 (X_1 - n \pi_1)^2, \dots, (X_K - n \pi_K)^2 ( X 1 − n π 1 ) 2 , … , ( X K − n π K ) 2 にもとづいて測ることができるので、ピアソンのカイ2乗検定統計量
Q ( X , π ) = ∑ i = 1 K ( X i − n π i ) 2 n π i Q(\boldsymbol{X}, \boldsymbol{\pi})
= \sum^K_{i=1} \frac{(X_i - n\pi_i)^2}{n \pi_i} Q ( X , π ) = i = 1 ∑ K n π i ( X i − n π i ) 2 を使って検定を行うことができる
(ここでX = ( X 1 , … , X K ) , π = ( π 1 , … , π K ) \boldsymbol{X}=(X_1, \dots, X_K), \boldsymbol{\pi}=(\pi_1, \dots, \pi_K) X = ( X 1 , … , X K ) , π = ( π 1 , … , π K )
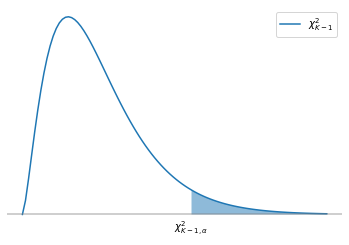
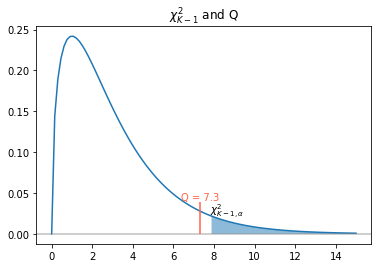
Q ( X , π ) Q(\boldsymbol{X}, \boldsymbol{\pi}) Q ( X , π ) H 0 H_0 H 0 χ K − 1 2 \chi^2_{K-1} χ K − 1 2
Q ( X , π ) > χ K − 1 , α 2 ⟹ reject Q(\boldsymbol{X}, \boldsymbol{\pi}) > \chi^2_{K-1, \alpha}
\implies \text{reject} Q ( X , π ) > χ K − 1 , α 2 ⟹ reject とする検定を考えればよいことになる。ただしχ K − 1 , α 2 \chi^2_{K-1, \alpha} χ K − 1 , α 2 χ K − 1 2 \chi^2_{K-1} χ K − 1 2 100 α 100\alpha 100 α
from scipy.stats import chi2

x = np.linspace(0, 20, 100)
dist = chi2(df=5)
y = dist.pdf(x)

fig, ax = plt.subplots()
ax.plot(x, y, label=r"$\chi^2_{K-1}$")
ax.axhline(color="gray", alpha=0.5)

alpha = 0.95
t = dist.ppf(alpha)
ax.text(t, -dist.pdf(t) * 0.7, r"$\chi^2_{K-1, \alpha}$", ha="center")
ax.fill_between(x=x[x > t], y1=y[x > t], alpha=.5)

ax.axis("off")
ax.legend()
fig.show()日本人1000人の血液型を調べたところ、次のようになったとする。
import pandas as pd
from scipy.stats import multinomial, chi2
n = 1000
pi = np.array([.4, .2, .3, .1])  # 理論確率

# データの生成
m = multinomial(n=1, p=pi)
x = m.rvs(size=n, random_state=100).sum(axis=0)
d = pd.DataFrame([x], columns=["A", "B", "O", "AB"], index=["観測度数"])
d日本人における血液型の割合は、おおよそA型40%、B型20%、O型30%、AB型10%といわれている(一般社団法人日本血液製剤協会
これを理論確率π \boldsymbol{\pi} π n × π n \times \boldsymbol{\pi} n × π
d.loc["期待度数", :] = pi * n
dピアソンのカイ2乗検定統計量
Q ( X , π ) = ∑ i = 1 K ( X i − n π i ) 2 n π i Q(\boldsymbol{X}, \boldsymbol{\pi})
= \sum^K_{i=1} \frac{(X_i - n\pi_i)^2}{n \pi_i} Q ( X , π ) = i = 1 ∑ K n π i ( X i − n π i ) 2 を計算すると次のようになる
Q = sum( (x - pi * n)**2 / (pi * n) )
Qfrom scipy.stats import chi2
K = len(d.columns)
df = K - 1
x = np.linspace(0, 15, 100)
dist = chi2(df=df)
y = dist.pdf(x)
fig, ax = plt.subplots()
ax.plot(x, y)
ax.axhline(color="gray", alpha=0.5)
ax.set(title=r"$\chi^2_{K-1}$ and Q")
alpha = 0.95
t = dist.ppf(alpha)
ax.text(t, dist.pdf(t) * 1.1, r"$\chi^2_{K-1, \alpha}$")
ax.fill_between(x=x[x > t], y1=y[x > t], alpha=.5)
ax.vlines(Q, 0, dist.pdf(Q) * 1.4, color="tomato")
ax.text(Q, dist.pdf(Q) * 1.5, f"Q = {Q:.1f}", ha="center", color="tomato")
fig.show()ワルド検定 ¶ 帰無仮説のもとでの漸近分布が正規分布で近似できるとき、それを利用して
R = { x ∈ X ∣ ∣ θ ^ − θ ∣ / V a r ( θ ^ ) ≥ z α / 2 } R = \{
x \in \mathcal{X} \mid |\hat{\theta} - \theta| / Var(\hat{\theta}) \geq z_{\alpha/2}
\} R = { x ∈ X ∣ ∣ θ ^ − θ ∣/ Va r ( θ ^ ) ≥ z α /2 } という棄却域を作る
スコア検定 ¶ スコア検定 (score test)はスコア関数
S n ( θ , X ) = d d θ log f n ( X ∣ θ ) S_n(\theta, \boldsymbol{X}) = \frac{d}{d \theta} \log f_n(\boldsymbol{X} \mid \theta) S n ( θ , X ) = d θ d log f n ( X ∣ θ ) に基づいた検定方式である。
E [ S n ( θ , X ) ] = 0 , Var ( S n ( θ , X ) ) = I n ( θ ) = n I 1 ( θ ) E\left[S_n(\theta, \boldsymbol{X})\right]=0, \operatorname{Var}\left(S_n(\theta, \boldsymbol{X})\right)=I_n(\theta)=n I_1(\theta) E [ S n ( θ , X ) ] = 0 , Var ( S n ( θ , X ) ) = I n ( θ ) = n I 1 ( θ ) となる。 S n ( θ , X ) S_n(\theta, \boldsymbol{X}) S n ( θ , X ) θ \theta θ
S n ( θ , X ) / n I 1 ( θ ) → d N ( 0 , 1 ) S_n(\theta, \boldsymbol{X}) / \sqrt{n I_1(\theta)} \rightarrow_d \mathcal{N}(0,1) S n ( θ , X ) / n I 1 ( θ ) → d N ( 0 , 1 ) となる. H 0 : θ = θ 0 H_0: \theta=\theta_0 H 0 : θ = θ 0 H 1 : θ ≠ θ 0 H_1: \theta \neq \theta_0 H 1 : θ = θ 0 S n ( θ 0 , X ) / n I ( θ 0 ) S_n\left(\theta_0, \boldsymbol{X}\right) / \sqrt{n I\left(\theta_0\right)} S n ( θ 0 , X ) / n I ( θ 0 )
R = { x ∈ X ∣ ∣ S n ( θ 0 , x ) ∣ n I 1 ( θ 0 ) ≥ z α / 2 } R=\left\{
\boldsymbol{x} \in \mathcal{X}
\left| \
\frac{ | S_n\left(\theta_0, \boldsymbol{x}\right) | }
{ \sqrt{n I_1\left(\theta_0\right)} }
\geq z_{\alpha / 2}
\right\}
\right. R = { x ∈ X ∣ ∣ n I 1 ( θ 0 ) ∣ S n ( θ 0 , x ) ∣ ≥ z α /2 } を棄却域とする検定をスコア検定という。