ポリコリック相関係数(polychoric correlation coefficient, 多分相関係数 とも)は順序尺度の変数同士での相関関係を測る係数。
推定方法
小杉考司(2013)を参考に、二段階の最尤推定を行う方法を紹介する。
まず、観測された順序尺度の変数の背景に連続尺度の変数が存在し、それらは二変量の標準正規分布に従うと仮定する。 2変量正規分布の空間を閾値で区切って離散化されたものが観測値として実現したと考える。
尤度関数
クロス集計表におけるセルの観測度数をとする()。
観測度数がセルに含まれる確率をとすれば、そのサンプルの尤度は
である。ここでは定数で、最尤推定においては推定に関わらないので気にしなくてよい。対数尤度は
相関を測りたい変数がの2つあるとし、変数の閾値を、変数の閾値をと表す()。 ここでである。
は相関係数の2変数正規分布を用いて
と表すことができる。
推定
閾値は次のように推定することができる。
ここでは観測された累積周辺分布である。
Source
import numpy as np
import pandas as pd
import seaborn as sns
import matplotlib.pyplot as plt
import matplotlib_fontja

fig, ax1 = plt.subplots(figsize=[4, 4])

k = 5
ticks = range(0, 2 * k, 2)
ticklabels_a = [f"a_{i}" for i in range(1, k + 1)]
ticklabels_b = [f"b_{i}" for i in range(1, k + 1)]

for tick in ticks:
    ax1.axhline(tick, color="gray")
    ax1.axvline(tick, color="gray")

cell_coords = range(1, 2 * k - 1, 2)
for i_show, i in enumerate(cell_coords, start=1):
    for j_show, j in enumerate(cell_coords, start=1):
        ax1.text(j, i, f"n_{i_show}{j_show}", ha="center", va="center")

ax1.set(ylabel="x", xticks=[], title="閾値のイメージ")
ax1.set_yticks(ticks=ticks, labels=ticklabels_a)
ax1.invert_yaxis()

ax2 = ax1.twiny()
ax2.set_xlim(ax1.get_xlim())
ax2.set_xlabel("y")
ax2.set_xticks(ticks=ticks, labels=ticklabels_b)
fig.show()
/tmp/ipykernel_1198361/2892077882.py:31: UserWarning: FigureCanvasAgg is non-interactive, and thus cannot be shown
fig.show()
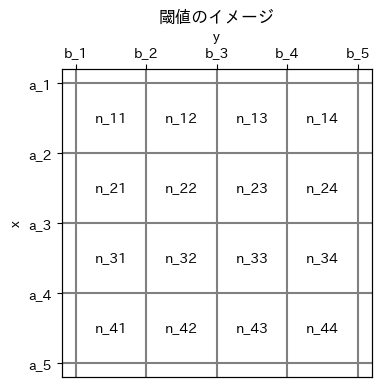
Source
import numpy as np
import pandas as pd
from scipy.stats import multivariate_normal, pearsonr

# generate data
n = 100
mean = [50, 0]
std = [10, 3]
rho = 0.5
cov = rho * std[0] * std[1]
Cov = np.array([
    [std[0]**2, cov],
    [cov, std[1]**2]
])

X = multivariate_normal.rvs(mean=mean, cov=Cov, size=n, random_state=0)

fig, ax = plt.subplots()
ax.scatter(X[:, 0], X[:, 1], alpha=.7)
ax.set(xlabel="x1", ylabel="x2", title=f"N(μ={mean}, Σ={Cov.tolist()}) (ρ={rho})")
fig.show()
/tmp/ipykernel_1198361/2450860406.py:21: UserWarning: FigureCanvasAgg is non-interactive, and thus cannot be shown
fig.show()
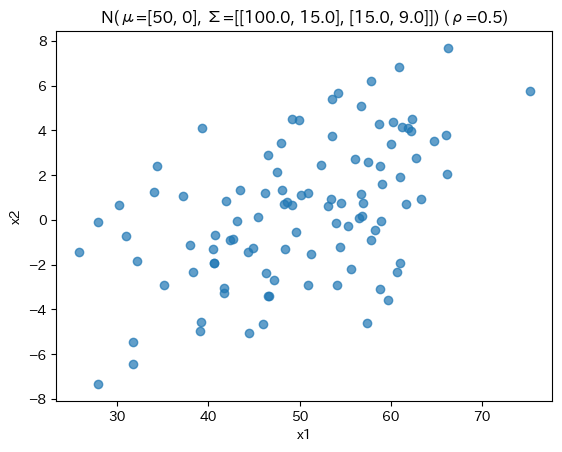
# 離散化
d1 = X[:, 0] >= X[:, 0].mean()
d2 = np.ones(shape=(n, ))
d2[(-4 <= X[:, 1]) & (X[:, 1] < 4)] = 2
d2[(4 <= X[:, 1])] = 3

D = np.array([d1, d2]).T
D = pd.DataFrame(D, columns=["d1", "d2"]).astype(int)
まずクロス集計表を作って観測度数を得る。
table = pd.crosstab(D["d1"], D["d2"])
tableクロス集計表を横軸や縦軸に向けて合計していき、累積周辺分布を得る
# 累積周辺分布
n = table.sum().sum()
Pi = table.sum(axis=1).cumsum().to_list() / n
Pj = table.sum(axis=0).cumsum().to_list() / n
print(f"{Pi=} {Pj=}")
Pi=array([0.48, 1. ]) Pj=array([0.08, 0.85, 1. ])
を推定する。、となるようにする
# 閾値a, bを推定
from scipy.stats import norm
a = norm.ppf(Pi, loc=0, scale=1)
b = norm.ppf(Pj, loc=0, scale=1)

# 簡単のためnp.infを使うが本格的に使う場合は大きな値(10とか100とか)をinfの代わりに使うと尤度が不連続になりづらかった
a = [-np.inf, *a]
b = [-np.inf, *b]

print(f"{a=}")
print(f"{b=}")
a=[-inf, np.float64(-0.05015358346473367), np.float64(inf)]
b=[-inf, np.float64(-1.4050715603096329), np.float64(1.0364333894937898), np.float64(inf)]
from scipy.stats import multivariate_normal

def log_likelihood(rho, a=a, b=b, table=table):
    Cov = np.array([
        [1, rho],
        [rho, 1]
    ])
    n = np.array(table)
    likelihood = 0
    for i in range(1, len(a)):
        for j in range(1, len(b)):
            ij = multivariate_normal.cdf([a[i], b[j]], mean=[0, 0], cov=Cov)
            ij = 0 if np.isnan(ij) else ij

            i1j = multivariate_normal.cdf([a[i-1], b[j]], mean=[0, 0], cov=Cov)
            i1j = 0 if np.isnan(i1j) else i1j

            ij1 = multivariate_normal.cdf([a[i], b[j-1]], mean=[0, 0], cov=Cov)
            ij1 = 0 if np.isnan(ij1) else ij1

            i1j1 = multivariate_normal.cdf([a[i-1], b[j-1]], mean=[0, 0], cov=Cov)
            i1j1 = 0 if np.isnan(i1j1) else i1j1
            pi = ij - i1j - ij1 + i1j1
            # ちなみにpiの推定は上記のように愚直にやらずとも scipy.stats の mvn.mvnun でもできる

            if pi > 0:
                likelihood += n[i-1, j-1] * np.log(pi)
    return likelihood

log_likelihood(rho=0.1)np.float64(-135.95432934194218)尤度を最大にするを探索する。
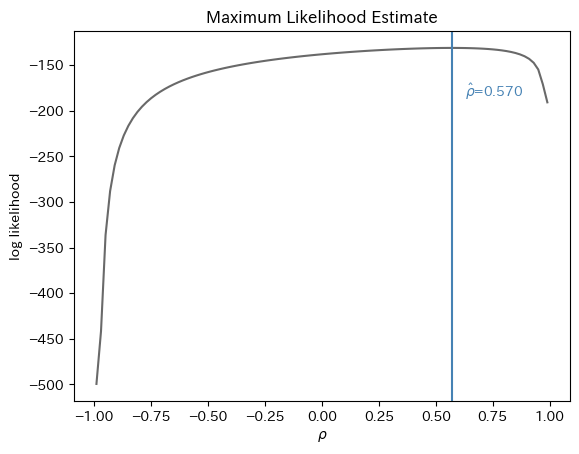
今回はがにあることがわかっているので、その範囲を細かく刻んで全部計算して最良のを推定値とする、という全探索法をつかうこともできる。
この方法を実際に行ったのが次の図である。
Source
# 最尤推定1: 全探索
rho_range = np.linspace(-0.99, 0.99, 100)
likelihoods = np.array([log_likelihood(rho) for rho in rho_range])
rho_hat = rho_range[np.argmax(likelihoods)]

fig, ax = plt.subplots()
ax.plot(rho_range, likelihoods, color="dimgray")
ax.set(xlabel=r"$\rho$", ylabel="log likelihood", title="Maximum Likelihood Estimate")

l = likelihoods[~np.isinf(likelihoods)]
y = -(l.max() - l.min()) / 2
ax.text(rho_hat * 1.1, y, r"$\hat{\rho}$"+f"={rho_hat:.3f}", color="steelblue")
ax.axvline(rho_hat, color="steelblue")

fig.show()
/tmp/ipykernel_1198361/84596571.py:15: UserWarning: FigureCanvasAgg is non-interactive, and thus cannot be shown
fig.show()
scipy.optimize.fminboundなどを使ってBrent法という最適化手法を用いると効率的である。
(実際、semopyやRyStatsなどのパッケージではscipyの最適化関数を呼び出すことでBrent法を使っている: semopy/polycorr.py)
# ※minimizeの関数に入れるために負の対数尤度にしている
from scipy.optimize import fminbound
fminbound(lambda rho: -log_likelihood(rho), -0.999, 0.999)np.float64(0.5697450392307374)ポリコリック相関係数の考え方まとめ
2つの順序尺度変数 があるとし、それぞれ次のように閾値で切って離散化されたと仮定する
ここで
:潜在的な連続変数
:それぞれのカデコリに対応するしきい値
:平均0、分散 1、相関 の2変量正規分布に従うと仮定
である。
を計算するときに使う閾値は単変量の正規分布の累積分布関数を使って次のように推定することができる。
ここでは観測された累積周辺分布である。
を観測値から推定することで、最尤推定する対象はだけになる
Drasgow, F. (1986). Polychoric and polyserial correlations In: Kotz S, Johnson N, editors. The Encyclopedia of Statistics.
こっちのほうが数式は簡潔でわかりやすい
import numpy as np
from scipy.optimize import minimize_scalar
from scipy.stats import multivariate_normal, norm


def polychoric_correlation(
    x: np.ndarray, y: np.ndarray, inf: float | int = 100, plot: bool = True
) -> float:
    """
    Estimate the polychoric correlation coefficient between two ordinal variables.

    Parameters
    ----------
    x : np.ndarray
        Ordinal variable X (integer-coded).
    y : np.ndarray
        Ordinal variable Y (integer-coded).
    inf : 閾値推定の上限・下限
        理論上は無限を使うが、数値計算上は別の値のほうが安定しやすい。実験用に指定可能にする

    Returns
    -------
    float
        Estimated polychoric correlation coefficient (rho).
    """

    # Step 1: Ensure inputs are numpy arrays and integer-coded
    x = np.asarray(x)
    y = np.asarray(y)

    if not np.issubdtype(x.dtype, np.integer) or not np.issubdtype(y.dtype, np.integer):
        raise ValueError("Inputs x and y must be integer-coded ordinal variables.")

    # Step 2: Identify unique ordinal levels
    x_levels = np.sort(np.unique(x))
    y_levels = np.sort(np.unique(y))

    # Step 3: Estimate thresholds from empirical marginal proportions
    def estimate_thresholds(values, inf):
        thresholds = []
        levels = np.sort(np.unique(values))
        for level in levels[:-1]:  # exclude top category
            p = np.mean(values <= level)
            thresholds.append(norm.ppf(p))  # τ_i = Φ⁻¹(P(X ≤ i))
        return np.concatenate(([-inf], thresholds, [inf]))

    tau_x = estimate_thresholds(x, inf)  # thresholds for X: τ_X
    tau_y = estimate_thresholds(y, inf)  # thresholds for Y: τ_Y

    # Step 4: Construct contingency table n_ij
    contingency = np.zeros((len(tau_x) - 1, len(tau_y) - 1), dtype=int)
    for i, xi in enumerate(x_levels):
        for j, yj in enumerate(y_levels):
            contingency[i, j] = np.sum((x == xi) & (y == yj))  # n_ij

    # Step 5: Define negative log-likelihood function based on P_ij = Φ₂(τ_i, τ_j; ρ)
    def neg_log_likelihood(rho):
        if not (-0.999 < rho < 0.999):
            return np.inf

        cov = np.array([[1, rho], [rho, 1]])
        log_likelihood = 0.0

        for i in range(len(tau_x) - 1):
            for j in range(len(tau_y) - 1):
                lower = [tau_x[i], tau_y[j]]
                upper = [tau_x[i + 1], tau_y[j + 1]]

                # P_ij = Φ₂(τ_{i}, τ_{j}) - Φ₂(τ_{i-1}, τ_{j}) - Φ₂(τ_{i}, τ_{j-1}) + Φ₂(τ_{i-1}, τ_{j-1})
                p_ij = (
                    multivariate_normal.cdf(upper, mean=[0, 0], cov=cov)
                    - multivariate_normal.cdf(
                        [lower[0], upper[1]], mean=[0, 0], cov=cov
                    )
                    - multivariate_normal.cdf(
                        [upper[0], lower[1]], mean=[0, 0], cov=cov
                    )
                    + multivariate_normal.cdf(lower, mean=[0, 0], cov=cov)
                )

                p_ij = max(p_ij, 1e-10)  # soft clipping

                if np.isnan(p_ij):
                    continue

                log_likelihood += contingency[i, j] * np.log(p_ij)

        return -log_likelihood  # minimize negative log-likelihood

    # Step 6: Optimize to find MLE for rho
    result = minimize_scalar(
        neg_log_likelihood, bounds=(-0.999, 0.999), method="bounded"
    )

    # plot for debug
    if plot:
        rho_range = np.linspace(-0.999, 0.999, 200)
        likelihoods = np.array([neg_log_likelihood(rho) for rho in rho_range])
        rho_hat = rho_range[np.argmin(likelihoods)]

        fig, ax = plt.subplots(figsize=[4, 3])
        ax.plot(rho_range, likelihoods, color="dimgray")
        ax.set(
            xlabel=r"$\rho$",
            ylabel="log likelihood",
            title="Maximum Likelihood Estimate",
        )
        l = likelihoods[~np.isinf(likelihoods)]
        # y = -(l.max() - l.min()) / 2
        y = np.min(likelihoods)
        ax.text(
            rho_hat * 1.1,
            y * 1.5,
            r"$\hat{\rho}$" + f"={rho_hat:.3f}",
            color="steelblue",
        )
        ax.axvline(rho_hat, color="steelblue")
        fig.show()

    return result.x
閾値の推定のとき下限と上限を無限以外の計算可能な値にすると対数尤度関数が不連続なジャンプをしにくい
x = D["d1"]
y = D["d2"]
polychoric_correlation(x, y, inf=np.inf)
/tmp/ipykernel_1198361/3882806428.py:118: UserWarning: FigureCanvasAgg is non-interactive, and thus cannot be shown
fig.show()
np.float64(0.5697450392307374)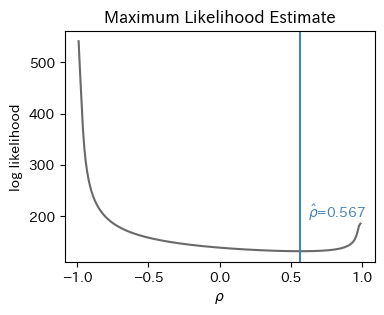
polychoric_correlation(x, y, inf=10)/tmp/ipykernel_1198361/3882806428.py:118: UserWarning: FigureCanvasAgg is non-interactive, and thus cannot be shown
fig.show()
np.float64(0.5697450392307374)# from ordinalcorr import polychoric
# polychoric(x, y)メモ:実装の高速化
問題:CDF計算
素朴に実装した場合の問題点
の評価のたびに、セルごとに scipy.stats.multivariate_normal の frozen オブジェクトを作り、 を4回呼んでいる
multivariate_normal.cdf は内部で数値積分を行うため、1点あたりの計算量が多く、結果に微小な誤差(揺らぎ)も入る。
from scipy.stats import multivariate_normal

point = np.array([0.5, 0.3])
rho = 0.5

# 改善前のパターン: 呼ぶたびに frozen オブジェクトを生成
%timeit -r 3 multivariate_normal(mean=[0, 0], cov=[[1, rho], [rho, 1]]).cdf(point)
74.8 μs ± 658 ns per loop (mean ± std. dev. of 3 runs, 10,000 loops each)
Owen の T 関数による閉形式
Owen の T 関数 (Owen, 1956)を使うと、2変量標準正規分布のCDFは、閉形式で厳密に書ける
は scipy.special.owens_t として提供されており、ベクトル化済みのC実装
import numpy as np
from scipy.special import ndtr, owens_t


def bvn_cdf(h, k, rho):
    """標準2変量正規CDF Φ₂(h, k; ρ)。h, k は配列可(簡略版: h, k ≠ 0 を仮定)"""
    h, k = np.asarray(h, float), np.asarray(k, float)
    denom = np.sqrt(1 - rho**2)
    a_h = (k - rho * h) / (h * denom)
    a_k = (h - rho * k) / (k * denom)
    delta = np.where((h * k < 0), 0.5, 0.0)
    return 0.5 * (ndtr(h) + ndtr(k)) - owens_t(h, a_h) - owens_t(k, a_k) - delta


# SciPy の数値積分版と比較 → 機械精度で一致
mvn = multivariate_normal([0, 0], [[1, 0.5], [0.5, 1]])

rng = np.random.default_rng(0)
points = rng.normal(size=(1000, 2))

err = np.abs(bvn_cdf(points[:, 0], points[:, 1], 0.5) - mvn.cdf(points))

print(f"最大誤差: {err.max():.2e}")  # ~1e-16
最大誤差: 2.22e-16
速度比較
# 1000点の Φ₂ 評価
%timeit -r 3 mvn.cdf(points)                            # 数値積分(frozen 再利用でも遅い)
%timeit -r 3 bvn_cdf(points[:, 0], points[:, 1], 0.5)      # Owen's T 閉形式
2.46 ms ± 4.86 μs per loop (mean ± std. dev. of 3 runs, 100 loops each)
109 μs ± 756 ns per loop (mean ± std. dev. of 3 runs, 10,000 loops each)