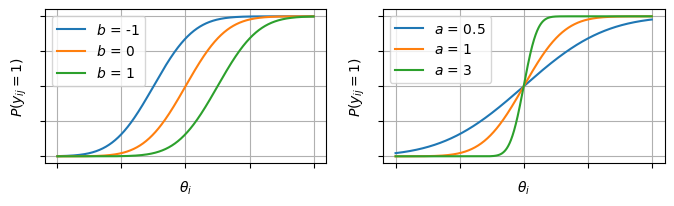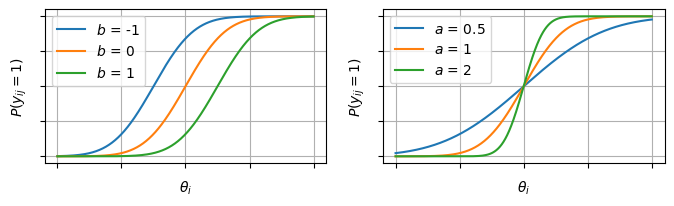古典的テスト理論(CTT)では項目の指標(困難度、識別力)や信頼性係数、測定の標準誤差などのいずれもがテストの受験者集団の性質に依存する問題があった。
IRTではテストに含まれる項目の難易度と受験者の能力を分離して表現できる。
IRTの考え方 ¶ IRTでは受験者の能力と項目(設問)の特徴を分離する。
テストを例にすると、IRTで使う観測データは「ある受験者i i i j j j u i j ∈ { 0 , 1 } u_{ij} \in \{0, 1\} u ij ∈ { 0 , 1 }
この観測値u i j u_{ij} u ij P ( u i j = 1 ) P(u_{ij} = 1) P ( u ij = 1 )
そして正解する確率P ( u i j = 1 ) P(u_{ij}=1) P ( u ij = 1 ) 受験者の能力θ i \theta_i θ i 、 設問の識別力a j a_j a j 、 設問の困難度b b b といったパラメータがあると考える。
from mermaid import Mermaid
Mermaid("""
graph BT
    theta(("能力θ")) --> P("正解する確率P(u=1)")
    a(("識別力a")) --> P
    b(("困難度b")) --> P
    P --> u["正解したかどうかu"]
""")正解する確率 P ( u i j = 1 ) P(u_{ij}=1) P ( u ij = 1 )
P ( u i j ∣ a j , b j , θ i ) = 1 1 + exp ( − a j ( θ i − b j ) ) \begin{aligned}
P(u_{ij} \mid a_j, b_j, \theta_i)
&= \frac{1}{1+\exp (- a_j(\theta_i - b_j))}
\end{aligned} P ( u ij ∣ a j , b j , θ i ) = 1 + exp ( − a j ( θ i − b j )) 1 このa j , b j , θ i a_j, b_j, \theta_i a j , b j , θ i u i j u_{ij} u ij
2PLMは、ロジスティック回帰の説明変数x x x θ \theta θ
2PLMを整理すると
P ( u i j ∣ a j , b j , θ i ) = 1 1 + exp ( − a j ( θ i − b j ) ) = 1 1 + exp ( − ( − a j b j + a j θ i ) ) \begin{aligned}
P(u_{ij} \mid a_j, b_j, \theta_i)
&= \frac{1}{1+\exp (- a_j(\theta_i - b_j))}\\
&= \frac{1}{1+\exp (- (- a_jb_j + a_j \theta_i))}
\end{aligned} P ( u ij ∣ a j , b j , θ i ) = 1 + exp ( − a j ( θ i − b j )) 1 = 1 + exp ( − ( − a j b j + a j θ i )) 1 で、傾き係数a j a_j a j β \beta β − a j b j -a_j b_j − a j b j α \alpha α θ i \theta_i θ i x i x_i x i
P ( y i = 1 ∣ α , β ) = 1 1 + exp ( − ( α + β x i ) ) P(y_i = 1 \mid \alpha, \beta)=\frac{1}{1+\exp (- (\alpha + \beta x_i))} P ( y i = 1 ∣ α , β ) = 1 + exp ( − ( α + β x i )) 1 ロジスティック回帰モデルでは観測値である説明変数x i x_i x i θ i \theta_i θ i
項目特性曲線 ¶ IRTでは 項目特性曲線(item characteristic curve: ICC) を使うことで受験者の能力と項目の困難度を分離する。
最も標準的なIRTモデルである2PLM(2 parameters logistic model)は
P j ( θ ) = 1 1 + exp ( − 1.7 a j ( θ − b j ) ) , − ∞ < θ < ∞ P_j(\theta)=\frac{1}{1+\exp \left(-1.7 a_j\left(\theta-b_j\right)\right)}, \quad-\infty<\theta<\infty P j ( θ ) = 1 + exp ( − 1.7 a j ( θ − b j ) ) 1 , − ∞ < θ < ∞ であり、これを図にしたものがICCになる。
import numpy as np
import matplotlib.pyplot as plt
from scipy.stats import norm
x = np.linspace(-4, 4, 1000)

fig, axes = plt.subplots(figsize=[8, 2], ncols=2)


a = 1
for beta in [-1, 0, 1]:
    axes[0].plot(x, norm.cdf(x, loc=beta, scale=1/a), label=r"$b$ = " + f"{beta}")
axes[0].set(xlabel=r"$\theta_i$", ylabel=r"$P(y_{ij} = 1)$", xticklabels=[], yticklabels=[])
axes[0].legend()
axes[0].grid(True)

beta = 0
for a in [0.5, 1, 3]:
    axes[1].plot(x, norm.cdf(x, loc=beta, scale=1/a), label=r"$a$ = " + f"{a}")
axes[1].set(xlabel=r"$\theta_i$", ylabel=r"$P(y_{ij} = 1)$", xticklabels=[], yticklabels=[])
axes[1].legend()
axes[1].grid(True)
困難度b b b θ \theta θ P ( y = 1 ) = 0.5 P(y=1)=0.5 P ( y = 1 ) = 0.5
ICCは2種類の解釈がある
能力値がθ \theta θ j j j 確率
能力値がθ \theta θ j j j 比率
後者が頻度主義的であり一般的で無理のない解釈
イメージ ¶ あるテストで、データセット(項目反応行列)が次のようになっていたとする。1は正解、0は不正解を意味する。
item1 item2 item3 item4 item5 person1 1 1 1 1 0 person2 1 1 1 0 1 person3 1 1 0 0 0 person4 1 0 0 0 1
item1は全員が正解している設問 → 困難度b b b a a a
item2~item4を見る限り、person1 > person2 > person3 のθ \theta θ
item4はθ \theta θ b b b
item5は他の項目との相関性がなくバラバラ → 識別力a a a
IRTモデルの仮定 ¶ 主な仮定
一次元性 :能力は1次元で表せる
局所独立性 :θ \theta θ
詳細:validation
一次元性 ¶ 2PLMのように1次元の能力パラメータθ \theta θ
データがこのモデルに合っているかどうかを確かめる必要がある
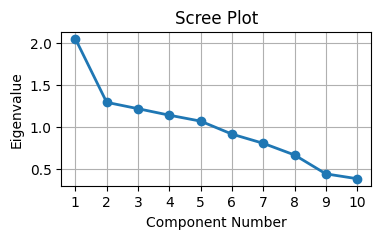
検証方法 ¶ スクリープロットを描き、第1主成分が突出して高ければ一次元性を満たすと判断する。厳密な判断基準はない。
# ------------------------------
# サンプルデータの生成
# ------------------------------
import numpy as np
import pandas as pd

np.random.seed(42)

n_persons = 100
n_items = 10

# 能力θと項目困難度bを設定
theta = np.random.normal(0, 1, n_persons)
b = np.random.normal(0, 0.2, n_items)
a = np.random.normal(0, 0.1, n_items)

# 2PLMで応答を生成
prob = 1 / (1 + np.exp(- a * (theta[:, None] - b)))
responses = np.random.binomial(1, prob)

df = pd.DataFrame(responses, columns=[f"item_{i+1}" for i in range(n_items)])
# print(df.head())

# ------------------------------
# スクリープロット
# ------------------------------
import numpy as np
from ordinalcorr import hetcor

cor_matrix = hetcor(df)
eigenvalues, _ = np.linalg.eig(cor_matrix)
eigenvalues = np.sort(eigenvalues)[::-1]

import matplotlib.pyplot as plt
plt.figure(figsize=(4, 2))
plt.plot(range(1, len(eigenvalues) + 1), eigenvalues, 'o-', linewidth=2)
plt.title("Scree Plot")
plt.xlabel("Component Number")
plt.ylabel("Eigenvalue")
plt.xticks(range(1, len(eigenvalues) + 1))
plt.grid(True)
plt.show()
局所独立性(local independence) ¶ 局所独立性(local independence) の定義は「能力θ \theta θ u j u_j u j
局所独立性が仮定される理由は2つある
θ \theta θ
尤度関数が作りやすいから
1. θ \theta θ ¶ IRTモデルでは、各項目への反応傾向(正答率)u j u_{j} u j θ \theta θ
θ \theta θ u j u_j u j θ \theta θ u j , u l u_j, u_l u j , u l c o r r ( u j , u l ) corr(u_j, u_l) corr ( u j , u l ) θ \theta θ
もしθ \theta θ u j u_j u j θ \theta θ
import graphviz

graphviz.Source("""
digraph g {
    graph [rankdir = LR];
    node [shape = square];
    u1
    u2
    u3
    node [shape = circle];
    theta [label="θ"]

    theta -> {u1, u2, u3}
    {rank = same; u1, u2, u3}
}
""")2. 尤度関数が作りやすいから ¶ 尤度関数(≒反応パターンの同時分布)を各項目の積
L ( T , θ ∣ U ) = ∏ i = 1 I ∏ j = 1 J P j ( θ i ∣ T ) u i j ⋅ { 1 − P j ( θ i ∣ T ) } 1 − u i j \begin{aligned}
L(\mathbf{T}, \boldsymbol{\theta} \mid \mathbf{U})
&=\prod_{i=1}^I \prod_{j=1}^J P_j(\theta_i \mid \mathbf{T})^{u_{i j}} \cdot \{ 1 - P_j(\theta_i \mid \mathbf{T}) \} ^{1-u_{i j}}
\end{aligned} L ( T , θ ∣ U ) = i = 1 ∏ I j = 1 ∏ J P j ( θ i ∣ T ) u ij ⋅ { 1 − P j ( θ i ∣ T ) } 1 − u ij とするために、θ \theta θ T \mathbf{T} T u i j u_{i j} u ij U \mathbf{U} U P j ( θ i ∣ T ) P_j(\theta_i \mid \mathbf{T}) P j ( θ i ∣ T )
局所独立性の正確な検証は難しいが、Q 3 Q_3 Q 3
Q 3 Q_3 Q 3
という考え方をとっている。
目安としては、「Q 3 > 0.20 Q_3 > 0.20 Q 3 > 0.20
モデル ¶ i i i j j j y i j y_{ij} y ij { 0 , 1 } \{0, 1\} { 0 , 1 }
y i j y_{ij} y ij θ i ∈ R \theta_i \in \mathbb{R} θ i ∈ R θ i \theta_i θ i b j b_j b j y i j y_{ij} y ij
y i j = { 0 if θ i < b j 1 if θ i ≥ b j y_{ij}
= \begin{cases}
0 & \text{ if } \theta_i < b_j\\
1 & \text{ if } \theta_i \geq b_j\\
\end{cases} y ij = { 0 1 if θ i < b j if θ i ≥ b j 1パラメータ正規累積モデル ¶ しかし、実際には被験者i i i ε i j ∼ N ( 0 , σ ε 2 ) \varepsilon_{ij} \sim N(0, \sigma^2_{\varepsilon}) ε ij ∼ N ( 0 , σ ε 2 )
y i j = { 0 if ( θ i − ε i j ) < b j 1 if ( θ i − ε i j ) ≥ b j y_{ij}
= \begin{cases}
0 & \text{ if } (\theta_i - \varepsilon_{ij}) < b_j\\
1 & \text{ if } (\theta_i - \varepsilon_{ij}) \geq b_j\\
\end{cases} y ij = { 0 1 if ( θ i − ε ij ) < b j if ( θ i − ε ij ) ≥ b j とする。誤差が確率変数のため、y i j y_{ij} y ij b j b_j b j
y i j = { 0 if ( θ i − ε i j − b j ) < 0 1 if ( θ i − ε i j − b j ) ≥ 0 y_{ij}
= \begin{cases}
0 & \text{ if } (\theta_i - \varepsilon_{ij} - b_j) < 0\\
1 & \text{ if } (\theta_i - \varepsilon_{ij} - b_j) \geq 0\\
\end{cases} y ij = { 0 1 if ( θ i − ε ij − b j ) < 0 if ( θ i − ε ij − b j ) ≥ 0 となる。θ i − ε i j − b j ∼ N ( θ i − b j , σ ε 2 ) \theta_i - \varepsilon_{ij} - b_j \sim N(\theta_i - b_j, \sigma^2_{\varepsilon}) θ i − ε ij − b j ∼ N ( θ i − b j , σ ε 2 ) ε i j \varepsilon_{ij} ε ij
y i j = { 0 if ( θ i − b j ) < ε i j 1 if ( θ i − b j ) ≥ ε i j y_{ij}
= \begin{cases}
0 & \text{ if } (\theta_i - b_j) < \varepsilon_{ij}\\
1 & \text{ if } (\theta_i - b_j) \geq \varepsilon_{ij}\\
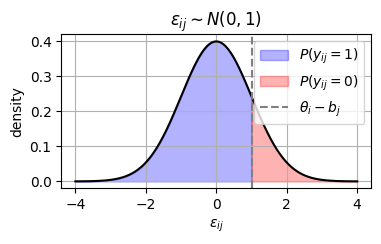
\end{cases} y ij = { 0 1 if ( θ i − b j ) < ε ij if ( θ i − b j ) ≥ ε ij でもあるので「y i j = 1 y_{ij}=1 y ij = 1 ε i j \varepsilon_{ij} ε ij θ i − b j \theta_i - b_j θ i − b j
仮にε i j \varepsilon_{ij} ε ij σ ε 2 = 1 \sigma^2_{\varepsilon} = 1 σ ε 2 = 1 θ i \theta_i θ i j j j
P ( y i j = 1 ) = P ( ε i j ≤ θ i − b j ) = ∫ − ∞ ( θ i − b j ) 1 2 π exp ( − z 2 2 ) d z \begin{aligned}
P(y_{ij} = 1)
&= P(\varepsilon_{ij} \leq \theta_i - b_j)\\
&= \int_{-\infty}^{\left(\theta_i-b_j\right)} \frac{1}{\sqrt{2 \pi}} \exp \left(-\frac{z^2}{2}\right) d z
\end{aligned} P ( y ij = 1 ) = P ( ε ij ≤ θ i − b j ) = ∫ − ∞ ( θ i − b j ) 2 π 1 exp ( − 2 z 2 ) d z となる(最後のは、ε i j \varepsilon_{ij} ε ij − ∞ -\infty − ∞ k θ i − b j k\theta_i-b_j k θ i − b j P ( ε i j ≤ θ i − b j ) P(\varepsilon_{ij} \leq \theta_i - b_j) P ( ε ij ≤ θ i − b j )
import numpy as np
import matplotlib.pyplot as plt
from scipy.stats import norm
epsilon = np.linspace(-4, 4, 1000)
y = norm.pdf(epsilon)
fig, ax = plt.subplots(figsize=[4,2])
ax.plot(epsilon, y, 'k-')

c = 1

ax.fill_between(epsilon, y, where=(epsilon < c), color='blue', alpha=0.3, label=r'$P(y_{ij} = 1)$')
ax.fill_between(epsilon, y, where=(epsilon >= c), color='red', alpha=0.3, label=r'$P(y_{ij} = 0)$')
ax.axvline(x=c, color='grey', linestyle='--', label=r'$\theta_i - b_j$')
ax.set(
    title=r'$\varepsilon_{ij} \sim N(0, 1)$',
    xlabel=r"$\varepsilon_{ij}$",
    ylabel="density"
)
ax.legend()
ax.grid(True)
fig.show()
2パラメータ正規累積モデル ¶ σ ε 2 \sigma^2_{\varepsilon} σ ε 2 σ ε 2 = 1 / a j \sigma^2_{\varepsilon}=1/a_j σ ε 2 = 1/ a j
ε i j ∼ N ( 0 , 1 a j ) \varepsilon_{ij} \sim N\left(0, \frac{1}{a_j}\right) ε ij ∼ N ( 0 , a j 1 ) となる。両辺をa j a_j a j a j ε i j ∼ N ( 0 , 1 ) a_j \varepsilon_{ij} \sim N(0, 1) a j ε ij ∼ N ( 0 , 1 ) a i a_i a i
P ( y i j = 1 ) = P ( a j ε i j ≤ θ i − b j ) = ∫ − ∞ a j ( θ i − b j ) 1 2 π exp ( − z 2 2 ) d z \begin{aligned}
P(y_{ij} = 1)
&= P(a_j \varepsilon_{ij} \leq \theta_i - b_j)\\
&= \int_{-\infty}^{ a_j (\theta_i-b_j)} \frac{1}{\sqrt{2 \pi}} \exp \left(-\frac{z^2}{2}\right) d z
\end{aligned} P ( y ij = 1 ) = P ( a j ε ij ≤ θ i − b j ) = ∫ − ∞ a j ( θ i − b j ) 2 π 1 exp ( − 2 z 2 ) d z となる。
b j b_j b j θ i − b j \theta_i - b_j θ i − b j P ( y i j = 1 ) P(y_{ij} = 1) P ( y ij = 1 ) y i j = 1 y_{ij} = 1 y ij = 1 b j b_j b j 項目困難度(item difficulty) と呼ばれる。
またa j a_j a j ε i j \varepsilon_{ij} ε ij θ i − b j \theta_i - b_j θ i − b j P ( y i j = 1 ) P(y_{ij} = 1) P ( y ij = 1 ) θ i \theta_i θ i P ( y i j = 1 ) P(y_{ij} = 1) P ( y ij = 1 ) a j a_j a j 項目識別力(item discrimination) と呼ばれる。
import numpy as np
import matplotlib.pyplot as plt
from scipy.stats import norm
x = np.linspace(-4, 4, 1000)

fig, axes = plt.subplots(figsize=[8, 2], ncols=2)


a = 1
for beta in [-1, 0, 1]:
    axes[0].plot(x, norm.cdf(x, loc=beta, scale=1/a), label=r"$b$ = " + f"{beta}")
axes[0].set(xlabel=r"$\theta_i$", ylabel=r"$P(y_{ij} = 1)$", xticklabels=[], yticklabels=[])
axes[0].legend()
axes[0].grid(True)

beta = 0
for a in [0.5, 1, 2]:
    axes[1].plot(x, norm.cdf(x, loc=beta, scale=1/a), label=r"$a$ = " + f"{a}")
axes[1].set(xlabel=r"$\theta_i$", ylabel=r"$P(y_{ij} = 1)$", xticklabels=[], yticklabels=[])
axes[1].legend()
axes[1].grid(True)

fig.show()なお横軸にθ i \theta_i θ i P ( y i j = 1 ) P(y_{ij}=1) P ( y ij = 1 ) 項目特性曲線 (item characteristic curve: ICC) と呼ばれる。
項目パラメータの推定 ¶ 主に2つのアプローチがある
能力パラメータθ \theta θ a , b a,b a , b
能力パラメータθ \theta θ 消去 して項目パラメータa , b a,b a , b
最尤推定法の場合、1~3PLMではEMアルゴリズムが多く(統計ソフトウェアでもデフォルト)、4PLMや多次元IRTモデルといった複雑なモデルではMHRM(Metropolis–Hastings Robbins–Monro)などが使われる
最尤推定法について ¶ 尤度関数は項目パラメータT \mathbf{T} T U \mathbf{U} U
尤度関数
L ( T , θ ∣ U ) = ∏ i = 1 I L ( T , θ i ∣ u i ) = ∏ i = 1 I ∏ j = 1 J P j ( θ i ∣ T ) u i j Q j ( θ i ∣ T ) 1 − u i j \begin{aligned}
L(\mathbf{T}, \boldsymbol{\theta} \mid \mathbf{U})
&=\prod_{i=1}^I L(\mathbf{T}, \theta_i \mid \mathbf{u}_i) \\
&=\prod_{i=1}^I \prod_{j=1}^J P_j(\theta_i \mid \mathbf{T})^{u_{i j}} Q_j(\theta_i \mid \mathbf{T})^{1-u_{i j}}
\end{aligned} L ( T , θ ∣ U ) = i = 1 ∏ I L ( T , θ i ∣ u i ) = i = 1 ∏ I j = 1 ∏ J P j ( θ i ∣ T ) u ij Q j ( θ i ∣ T ) 1 − u ij 同時最尤推定法 ¶ 以下の手順で解く。
パラメータの初期値を与える
θ \mathbf{\theta} θ T \mathbf{T} T
T \mathbf{T} T θ \mathbf{\theta} θ
2.と3.を収束するまで繰り返す
同時最尤推定法は1PLMでは十分機能するが、2PLM以上の複雑なモデルだと解が収束しないことがあったり、項目パラメータが一致性をもたないなどの問題がある。そのため、実際に多くのIRTソフトウェア(IRTPRO, BILOG-MG, ICLなど)で用いられているのは周辺最尤推定法である。
周辺最尤推定法 ¶ Bock & Lieberman (1970)が提案した 周辺最尤推定法(marginal likelihood estimation) では尤度関数から θ \theta θ L M L_M L M
L M ( T ∣ U ) = ∏ i = 1 I ∫ − ∞ ∞ L ( T , θ i ∣ u i ) f ( θ i ) d θ i = ∏ i = 1 I ∫ − ∞ ∞ { ∏ j = 1 J P j ( θ i ) u i j Q j ( θ i ) 1 − u i j } f ( θ i ) d θ i \begin{aligned}
L_M(\mathbf{T} \mid \mathbf{U}) & =\prod_{i=1}^I \int_{-\infty}^{\infty} L(\mathbf{T}, \theta_i \mid \mathbf{u}_i) f(\theta_i) d \theta_i \\
& =\prod_{i=1}^I \int_{-\infty}^{\infty} \left \{\prod_{j=1}^J P_j(\theta_i)^{u_{i j}} Q_j(\theta_i)^{1-u_{i j}} \right\} f(\theta_i) d \theta_i
\end{aligned} L M ( T ∣ U ) = i = 1 ∏ I ∫ − ∞ ∞ L ( T , θ i ∣ u i ) f ( θ i ) d θ i = i = 1 ∏ I ∫ − ∞ ∞ { j = 1 ∏ J P j ( θ i ) u ij Q j ( θ i ) 1 − u ij } f ( θ i ) d θ i ここでf ( θ i ) f(\theta_i) f ( θ i ) θ \theta θ N ( 0 , 1 ) \mathcal{N}(0,1) N ( 0 , 1 ) θ \theta θ θ \theta θ
しかし、周辺尤度の対数をとった対数周辺尤度関数
ln L M ( T ∣ U ) = ∑ i = 1 I ln { ∫ − ∞ ∞ L ( T , θ i ∣ u i ) f ( θ i ) d θ i } \ln L_M(\mathbf{T} \mid \mathbf{U})=\sum_{i=1}^I \ln \left\{\int_{-\infty}^{\infty} L\left(\mathbf{T}, \theta_i \mid \mathbf{u}_i\right) f\left(\theta_i\right) d \theta_i\right\} ln L M ( T ∣ U ) = i = 1 ∑ I ln { ∫ − ∞ ∞ L ( T , θ i ∣ u i ) f ( θ i ) d θ i } を使ってのパラメータ推定は計算が難しかった。
そこでBock & Aitkin (1981)が EMアルゴリズム (Dempster et al., 1977)の利用を提案した。
EMアルゴリズム ¶ 対数周辺尤度関数のうち積分の対象となっている関数
L C ( T ∣ u i , θ i ) = L ( T , θ i ∣ u i ) f ( θ i ) L_C(\mathbf{T} \mid \mathbf{u}_i, \theta_i)=L(\mathbf{T}, \theta_i \mid \mathbf{u}_i) f(\theta_i) L C ( T ∣ u i , θ i ) = L ( T , θ i ∣ u i ) f ( θ i ) は項目パラメータが与えられたときの反応u i \mathbf{u}_i u i θ i \theta_i θ i U \mathbf{U} U θ \boldsymbol{\theta} θ L C ( T ∣ u i , θ i ) L_C(\mathbf{T} \mid \mathbf{u}_i, \theta_i) L C ( T ∣ u i , θ i )
L C ( T ∣ U , θ ) = ∏ i = 1 I L C ( T ∣ u i , θ i ) L_C(\mathbf{T} \mid \mathbf{U}, \boldsymbol{\theta})=\prod_{i=1}^I L_C(\mathbf{T} \mid \mathbf{u}_i, \theta_i) L C ( T ∣ U , θ ) = i = 1 ∏ I L C ( T ∣ u i , θ i ) を最大化して最尤推定値を得ることができる。このように考えたとき、L C ( T ∣ U , θ ) L_C(\mathbf{T} \mid \mathbf{U}, \boldsymbol{\theta}) L C ( T ∣ U , θ ) 完全データ尤度関数(complete data likelihood function) といい、その対数をとった
ℓ ( T ∣ U , θ ) = ln L C ( T ∣ U , θ ) = ∑ i = 1 I ln L C ( T ∣ u i , θ i ) \begin{aligned}
\ell(\mathbf{T} \mid \mathbf{U}, \boldsymbol{\theta})
&= \ln L_C(\mathbf{T} \mid \mathbf{U}, \boldsymbol{\theta}) \\
&=\sum_{i=1}^I \ln L_C\left(\mathbf{T} \mid \mathbf{u}_i, \theta_i\right)
\end{aligned} ℓ ( T ∣ U , θ ) = ln L C ( T ∣ U , θ ) = i = 1 ∑ I ln L C ( T ∣ u i , θ i ) を 対数完全データ尤度関数(log complete data likelihood function) という。
θ \boldsymbol{\theta} θ θ \boldsymbol{\theta} θ θ \boldsymbol{\theta} θ Eステップ と呼ばれる)。そして項目パラメータT \mathbf{T} T Mステップ という)。EMアルゴリズムではEステップとMステップを交互に繰り返す。
E-step (expectation step)
E-step では、項目パラメータの現在の推定値T old \mathbf{T}^{\text{old}} T old θ \theta θ f ( θ ∣ U , T old ) f(\theta \mid \mathbf{U}, \mathbf{T}^{\text{old}}) f ( θ ∣ U , T old ) ln L C ( T ∣ U , θ ) \ln L_C(\mathbf{T} \mid \mathbf{U}, \boldsymbol{\theta}) ln L C ( T ∣ U , θ )
Q ( T ∣ T old ) = E θ [ ln L C ( T ∣ U , θ ) ] = ∫ − ∞ ∞ ln L C ( T ∣ U , θ ) f ( θ ∣ U , T old ) d θ \begin{aligned}
Q(\mathbf{T}\mid \mathbf{T}^{\text{old}})
&= \operatorname{E}_{\theta} \big[ \ln L_C(\mathbf{T} \mid \mathbf{U}, \boldsymbol{\theta}) \big]\\
&= \int_{-\infty}^{\infty} \ln L_C(\mathbf{T} \mid \mathbf{U}, \boldsymbol{\theta})
f(\theta \mid \mathbf{U}, \mathbf{T}^{\text{old}})
d \theta
\end{aligned} Q ( T ∣ T old ) = E θ [ ln L C ( T ∣ U , θ ) ] = ∫ − ∞ ∞ ln L C ( T ∣ U , θ ) f ( θ ∣ U , T old ) d θ という計算を行う。この積分計算はGauss–Hermiteなどの数値積分法で近似される。
M-step (maximization step)
Q ( T ∣ T old ) Q(\mathbf{T}\mid \mathbf{T}^{\text{old}}) Q ( T ∣ T old ) T new \mathbf{T}^{\text{new}} T new
T new : = arg max T Q ( T ∣ T old ) \mathbf{T}^{\text{new}} := \operatorname*{\text{arg max}}_{\mathbf{T}} Q(\mathbf{T}\mid \mathbf{T}^{\text{old}}) T new := T arg max Q ( T ∣ T old ) T new \mathbf{T}^{\text{new}} T new T old \mathbf{T}^{\text{old}} T old
能力パラメータの推定 ¶ 最尤推定法による推定 ¶ 例として2PLMを考え、項目パラメータa , b a,b a , b θ \theta θ
局所独立性の仮定のもとで、受験者i i i θ i \theta_i θ i u i \mathbf{u}_i u i
P ( u i ∣ θ i ) = ∏ j = 1 J P j ( θ i ) u i j Q j ( θ i ) 1 − u i j P(\mathbf{u}_i \mid \theta_i)=\prod_{j=1}^J P_j(\theta_i)^{u_{i j}} Q_j(\theta_i)^{1-u_{i j}} P ( u i ∣ θ i ) = j = 1 ∏ J P j ( θ i ) u ij Q j ( θ i ) 1 − u ij となる。ここでP j ( θ i ) P_j(\theta_i) P j ( θ i ) θ i \theta_i θ i j j j
P j ( θ ) = 1 1 + exp ( − 1.7 a j ( θ − b j ) ) , − ∞ < θ < ∞ P_j(\theta)=\frac{1}{1+\exp \left(-1.7 a_j\left(\theta-b_j\right)\right)}, \quad-\infty<\theta<\infty P j ( θ ) = 1 + exp ( − 1.7 a j ( θ − b j ) ) 1 , − ∞ < θ < ∞ で表現される。Q j ( θ i ) Q_j(\theta_i) Q j ( θ i ) Q j ( θ i ) : = 1 − P j ( θ i ) Q_j(\theta_i):= 1 - P_j(\theta_i) Q j ( θ i ) := 1 − P j ( θ i )
項目反応が既知であればP ( u i ∣ θ i ) P(\mathbf{u}_i \mid \theta_i) P ( u i ∣ θ i ) L ( θ i ∣ u i ) L(\theta_i \mid \mathbf{u}_i) L ( θ i ∣ u i )
例:mirtパッケージに実装された様々なパラメータ推定法 ¶ Rのmirtパッケージは多次元IRTモデルも推定可能で、モダンなパラメータ推定方法も実装されている
mirt()関数のドキュメント methodの欄に色々書いてある
'EM': the standard EM algorithm with fixed quadrature (default)
'QMCEM': quasi-Monte Carlo EM estimation
'MHRM':Metropolis–Hastings Robbins–Monro Algorithm
'SEM': Stochastic EM algorithm (first two stages of the MH-RM stage using an optimizer other than a single Newton-Raphson iteration)
1~3次元IRTまではEMで足りる様子。
The ‘EM’ is generally effective with 1-3 factors, but methods such as the ‘QMCEM’, ‘MCEM’, ‘SEM’, or ‘MHRM’ should be used when the dimensions are 3 or more.
Cai, L. (2010). High-dimensional Exploratory Item Factor Analysis by A Metropolis–Hastings Robbins–Monro Algorithm. Psychometrika , 75 (1), 33–57. 10.1007/s11336-009-9136-x