次元性の仮定の検証
IRTでは、そのテストが測ろうとしている構成概念(スコア)の次元数を仮定してモデルを当てはめる。そのため、データがその仮定に合致するかを検討するというもの。
スクリープロット
相関行列の固有値を降順に描いたプロット。
例えば第1成分から第2成分にかけて一気にカーブが下がってそれ以降はなだらかになっている(第1主成分だけで多くを説明できる)場合は1次元だとみなして妥当
Source
# ------------------------------
# サンプルデータの生成
# ------------------------------
import numpy as np
import pandas as pd

np.random.seed(42)

n_persons = 100
n_items = 10

# 能力θと項目困難度bを設定
theta = np.random.normal(0, 1, n_persons)
b = np.random.normal(0, 0.2, n_items)
a = np.random.normal(0, 0.1, n_items)

# 2PLMで応答を生成
prob = 1 / (1 + np.exp(- a * (theta[:, None] - b)))
responses = np.random.binomial(1, prob)

df = pd.DataFrame(responses, columns=[f"item_{i+1}" for i in range(n_items)])
# print(df.head())

# ------------------------------
# スクリープロット
# ------------------------------
import numpy as np
from ordinalcorr import hetcor

cor_matrix = hetcor(df)
eigenvalues, _ = np.linalg.eig(cor_matrix)
eigenvalues = np.sort(eigenvalues)[::-1]

import matplotlib.pyplot as plt
plt.figure(figsize=(4, 2))
plt.plot(range(1, len(eigenvalues) + 1), eigenvalues, 'o-', linewidth=2)
plt.title("Scree Plot")
plt.xlabel("Component Number")
plt.ylabel("Eigenvalue")
plt.xticks(range(1, len(eigenvalues) + 1))
plt.grid(True)
plt.show()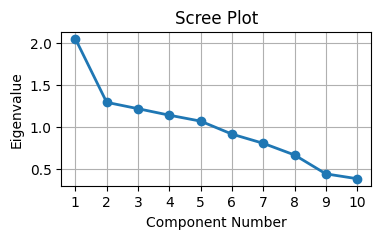
info - Unknown Directive
info - Unknown Directive[Hattie, J. (1985). Methodology review: assessing unidimensionality of tests and ltenls. Applied psychological measurement, 9(2), 139-164.](https://journals.sagepub.com/doi/10.1177/014662168500900204) は様々な次元性の検証方法の長短をレビューしている
局所独立性の仮定の検証
局所独立性(local independence) とは、能力を1つの値に固定したとき、各テスト項目への反応は互いに独立であるという性質。
言い換えると「項目間の相関は能力という因子に起因していて、能力を固定してその影響を除外(統制)すれば項目間の相関はない」という考え方。
Source
import graphviz
graphviz.Source("""
digraph g {
    graph [rankdir = TB];
    node[shape = circle];
        theta [label=<<I>θ</I>>]
    node[shape = square];
        u1    [label=<<I>u<SUB>1</SUB></I>>]
        u2    [label=<<I>u<SUB>2</SUB></I>>]
        u3    [label=<<I>u<SUB>3</SUB></I>>]
    edge [];
        theta -> {u1, u2, u3}
}
""")統計量
統計量は局所独立性の検証に使われる統計量で、2つの項目のペアの残差の間の相関である。
目安としては、「の項目ペアは局所独立性の侵害を疑う必要がある」とされる
統計量は
によって項目間の相関関係が十分に説明されているとすれば、その影響を除去した残差得点同士の相関は0に近くなるはず
以外に項目間に相関をもたらす要因がある場合はの影響を除いてもなお相関が残る
という考え方をとっている。
は平均がゼロではなく、ややマイナスに偏る負のバイアスが指摘されている(Yen, 1984)。
バイアスを補正したバージョン(単純にゼロで引く)も検討されている(Christensen et al., 2017)
「がいくつ以下ならいい」という基準値が不明瞭(慣例的に0.2と言われがちだが実際の論文では0.3以下基準のものがあったり、まちまち)
Q3の標本分布はわからないが、Finch & Jeffers (2016) はpermutation testによりType I errorと検出率を推定する方法を提案している。
Rだと {mirt} パッケージなどで推定できる
model <- mirt(data, 1) # 1次元IRTのfit
residuals(model, type = 'Q3') # 残差分析ジャックナイフ識別力指標(JSI)
ジャックナイフ識別力指標 ( jackknife slope index, JSI ; Houts & Edwards, 2013) はテスト中の項目が推定から除外されたときに項目の識別力の推定値が受ける影響を定量化する。
局所依存が発生している項目ペアでは識別力パラメータの推定にバイアスがかかるため、ペアの片方を除外した場合の識別力の変動を定量化する。
:項目が推定から除外されたときの項目の識別力パラメータ
JSIが大きければ、そのペアにLDが発生しているとみなす。標準誤差が含まれるためJSIの大小はサンプルサイズにも依存するため、 テスト中の全JSIの平均から2標準偏差離れた項目を注意項目とみなす という基準が提案されている。
Edwards et al.(2018) のシミュレーションによれば JSI は𝑄ଷや𝐺ଶといった古典的な指標よりも検出力が高く,誤検知も起こりにくい。
例えばRだと {mirt} パッケージで推定できる
model <- mirt(data, 1) # 1次元IRTのfit
residuals(model, type = 'JSI') # 残差分析モデルの検証
クロンバックのα
❌️CTTなので標本依存性がある
❌️CTTにおける信頼性係数や、その推定量であるクロンバックのαは項目数が増えるとαも上がってしまい、精度が低いことが知られている
適合度
❌️IRTの個人適合度(統計量) → 正規分布に従い、例えば5%有意水準で適合度が低い受験者を検出できるが、適合していても5%は誤検出する
❌️IRTの項目適合度 → 受験者数が増えるとp-valueが5%未満(→適合していない)になりやすく、誤検出が多い
二値反応の項目について項目適合度を視覚的に見る方法としては、推定したと実測のの関係性が推定したパラメータによるICCでうまくフィットできているかを見る方法がある。
を5段階くらいにカットして
情報量関数
情報量関数は1つのテストについて検定のような良し悪しを判断する使われ方はされず、の値に対する情報量の多寡をみる
また2つのテストのどちらがより精度が高いかを相対効率で示すなどといった使われ方をされる。
スコアの検証
Messickの妥当性概念
Messickは妥当性検証のための側面を6つ挙げた。
| 側面(facet) | 内容(簡潔な説明) |
|---|---|
| ① 内容的妥当性(Content) | 測定内容が理論的構成概念をどれだけ網羅しているか |
| ② 構成概念妥当性(Substantive) | 測定が理論に基づき、認知的に妥当か |
| ③ 構造的妥当性(Structural) | 得点構造が想定した構成概念と整合しているか(因子構造など) |
| ④ 外的妥当性(External) | 他の指標との関係が理論通りか(収束的・弁別的妥当性) |
| ⑤ 結果的妥当性(Consequential) | 測定の利用が社会的に望ましい結果をもたらすか(公正性・偏りなど) |
| ⑥ 実証的妥当性(Generalizability) | 測定結果が一般化可能か(状況・集団を超えて妥当か) |
上記6つの側面にわたる証拠が備えられていることが望ましい。しかし妥当性検証とは尺度が利用されることで明らかになる証拠を積み重ねるプロセスであるため、最初から全部を備えることは不可能。
外的妥当性の検証
スコアが「人間の肌感覚」など何らかの先行的に存在する指標を模倣している場合は、その模倣具合からある程度妥当性を検証できる
例えば数件~数十件の受験者をサンプリングし、人間の肌感覚に従って昇順にソートしてもらい、それと推定されたの順序相関を確認する
- Christensen, K. B., Makransky, G., & Horton, M. (2016). Critical Values for Yen’s Q 3 : Identification of Local Dependence in the Rasch Model Using Residual Correlations. Applied Psychological Measurement, 41(3), 178–194. 10.1177/0146621616677520
- Yen, W. M. (1984). Effects of Local Item Dependence on the Fit and Equating Performance of the Three-Parameter Logistic Model. Applied Psychological Measurement, 8(2), 125–145. 10.1177/014662168400800201