正規累積モデル(normal ogive model) は基本的なIRTの考え方を示すモデル。正規累積モデルは概念上のわかり易さがある一方で、計算量の問題もあり、伝統的にはロジスティック・シグモイド関数により近似したロジスティックモデルが活用されてきた。そのため実際のところ最も基本的なIRTモデルはロジスティックモデルだが、そのベースになるのが正規累積モデル。
モデルの考え方
番目の被験者の番目の項目の値が二値であるとする(例えば正解・不正解だったり、アンケートの「あてはまる」「あてはまらない」という2件法など)。
の背後には潜在的な能力の連続量が存在し、が閾値を超えていたら1、超えていなければ0が観測されるとする。つまりが以下のように決まるとする。
しかし、実際には被験者の体調や運(たまたま正解できた)などにより、常にこのようにきれいに正解・不正解が決まるわけではないと考えられる。こうした誤差を表すパラメータも追加して
とする。誤差が確率変数のため、のとる値も確率変数として考えることができるようになる。を移項すると
となる。である。 を移項すれば
でもあるので「となるのは誤差が以下のとき」とわかる。
Source
import numpy as np
import matplotlib.pyplot as plt
from scipy.stats import norm
epsilon = np.linspace(-4, 4, 1000)
y = norm.pdf(epsilon)
fig, ax = plt.subplots(figsize=[4,2])
ax.plot(epsilon, y, 'k-')

c = 1

ax.fill_between(epsilon, y, where=(epsilon < c), color='blue', alpha=0.3, label=r'$P(y_{ij} = 1)$')
ax.fill_between(epsilon, y, where=(epsilon >= c), color='red', alpha=0.3, label=r'$P(y_{ij} = 0)$')
ax.axvline(x=c, color='grey', linestyle='--', label=r'$\theta_i - b_j$')
ax.set(
    title=r'$\varepsilon_{ij} \sim N(0, 1)$',
    xlabel=r"$\varepsilon_{ij}$",
    ylabel="density"
)
ax.legend()
ax.grid(True)
fig.show()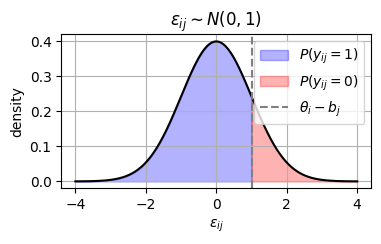
1パラメータ正規累積モデル
仮にが標準正規分布(の正規分布)に従うならば、特性値の人が項目に当てはまると回答する確率は
となる(最後のは、が従う標準正規分布のうち から までの範囲の面積がということ)。
Source
import numpy as np
import matplotlib.pyplot as plt
from scipy.stats import norm
x = np.linspace(-4, 4, 1000)

fig, ax = plt.subplots(figsize=[4, 2], ncols=1)

def icc(x, a, b):
    return norm.cdf(x, loc=b, scale=1/a)

a = 1
for b in [-1, 0, 1]:
    ax.plot(x, icc(x, a, b), label=r"$b$ = " + f"{b}")
ax.set(xlabel=r"$\theta_i$", ylabel=r"$P(y_{ij} = 1)$", xticklabels=[], yticklabels=[])
ax.legend()
ax.grid(True)

2パラメータ正規累積モデル
が項目ごとに異なる場合を考える。とすると、誤差の確率分布は
となる。両辺を倍すると、と表すことができ、引き続き標準正規分布を使うことができる。そのためモデルはが追加され
となる。
Source
import numpy as np
import matplotlib.pyplot as plt
from scipy.stats import norm
x = np.linspace(-4, 4, 1000)

fig, axes = plt.subplots(figsize=[8, 2], ncols=2)

def icc(x, a, b):
    return norm.cdf(x, loc=b, scale=1/a)

a = 1
for b in [-1, 0, 1]:
    axes[0].plot(x, icc(x, a, b), label=r"$b$ = " + f"{b}")
axes[0].set(xlabel=r"$\theta_i$", ylabel=r"$P(y_{ij} = 1)$", xticklabels=[], yticklabels=[])
axes[0].legend()
axes[0].grid(True)

b = 0
for a in [0.5, 1, 2]:
    axes[1].plot(x, icc(x, a, b), label=r"$a$ = " + f"{a}")
axes[1].set(xlabel=r"$\theta_i$", ylabel=r"$P(y_{ij} = 1)$", xticklabels=[], yticklabels=[])
axes[1].legend()
axes[1].grid(True)
なお横軸に、縦軸にをとったグラフは 項目特性曲線 (item characteristic curve: ICC) と呼ばれる。